สอน AI ด้วยข้อมูลของเราเองยังไง? ได้ค่ะ และไม่ต้องฝึกโมเดลยักษ์ทั้งตัวใหม่ — เทคนิค LoRA ฝึกแค่ตัวเสริมเล็กๆ (adapter) ประหยัด เร็ว และทำที่บ้านได้
How to train AI on your own data with LoRA & QLoRA — freeze the big model, train a tiny adapter.
📑 ช่วงเวลา / Chapters
How to train AI on your own data (LoRA & fine-tuning)
สอน AI ด้วยข้อมูลของเราเองยังไง? (LoRA)
สมมติเราอยากได้ AI ที่เขียนงานด้วยสำนวนของเราเอง ตอบลูกค้าด้วยน้ำเสียงแบรนด์เรา หรือรู้ข้อมูลเฉพาะของโรงเรียนเรา คำถามคือ เราต้องไปฝึกโมเดลยักษ์ทั้งตัวใหม่เลยไหมคะ คำตอบคือ ไม่ต้องเลยค่ะ วันนี้ครูนารีจะพาไปรู้จักวิธีสอน AI ด้วยข้อมูลของเราเอง ตั้งแต่แบบหนักๆ ไปจนถึงเทคนิคประหยัดที่ชื่อว่า LoRA ที่ทำที่บ้านก็ได้ ไปดูกันเลยค่ะ
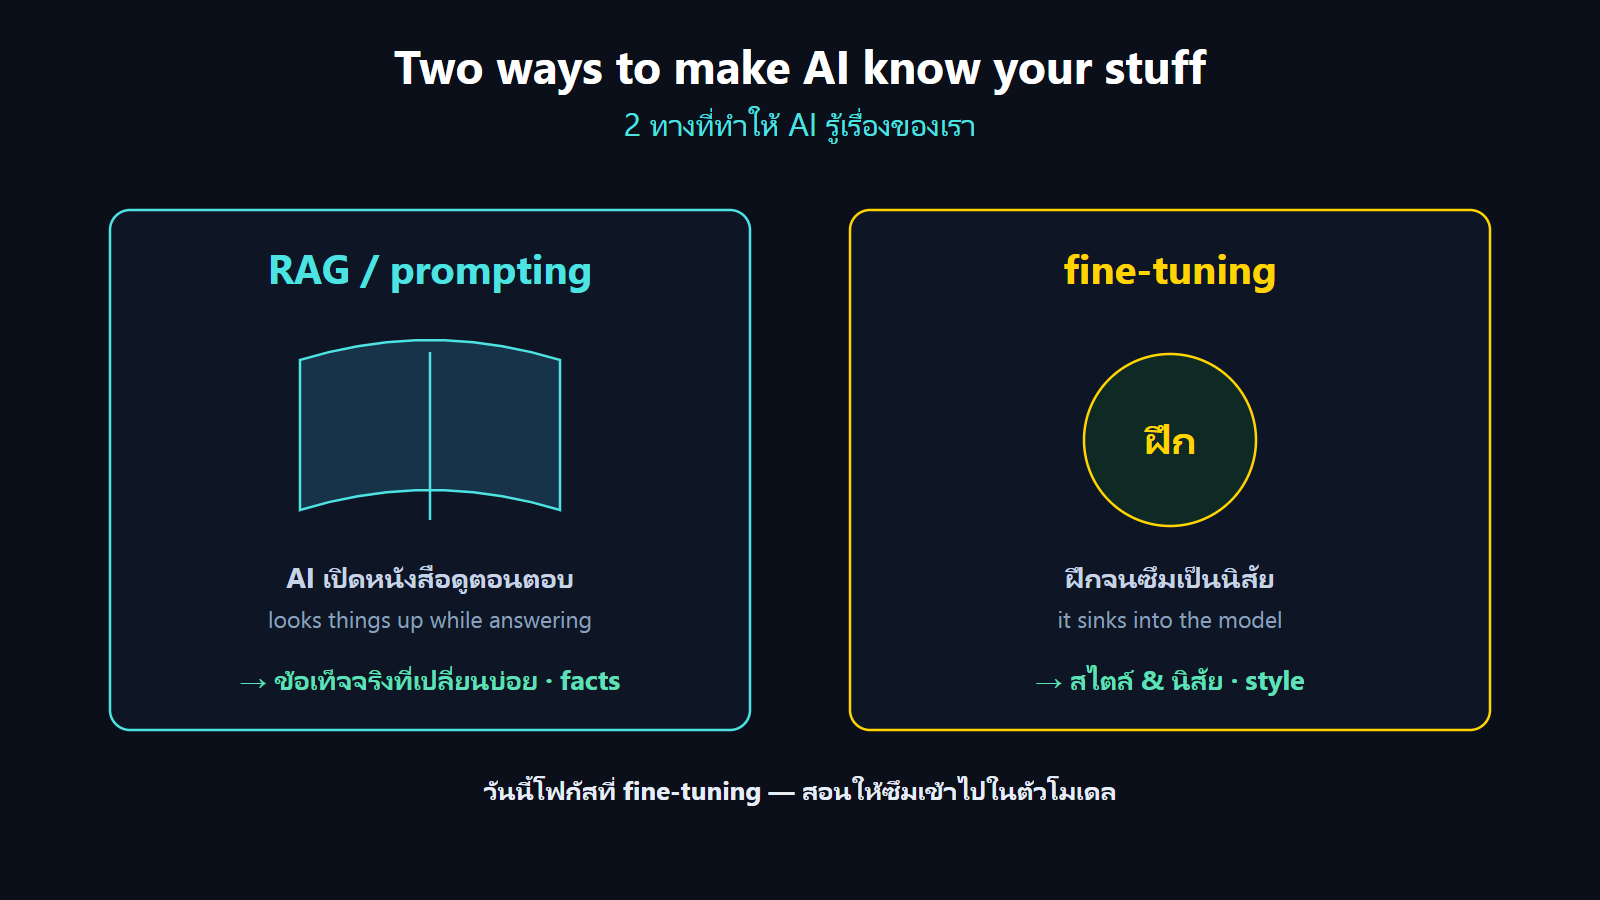
ก่อนอื่น การทำให้ AI รู้เรื่องของเรา มีสองทางใหญ่ๆ ค่ะ ทางแรกคือเอาข้อมูลไปแปะใน prompt หรือให้มันไปค้นเอกสารของเราตอนตอบ ที่เรียกว่า RAG ทางนี้เหมาะกับข้อมูลที่เป็นข้อเท็จจริง ที่เปลี่ยนบ่อยค่ะ ส่วนทางที่สอง คือการฝึกตัวโมเดลจริงๆ หรือ fine-tuning พูดให้เห็นภาพนะคะ RAG เหมือนให้ AI เปิดหนังสือดูตอนตอบ ส่วน fine-tuning เหมือนให้มันท่องจนซึมเป็นนิสัย เปลี่ยนสไตล์ น้ำเสียง และวิธีคิดให้ติดตัวโมเดลไปเลย วันนี้เราจะโฟกัสที่ทางที่สองค่ะ
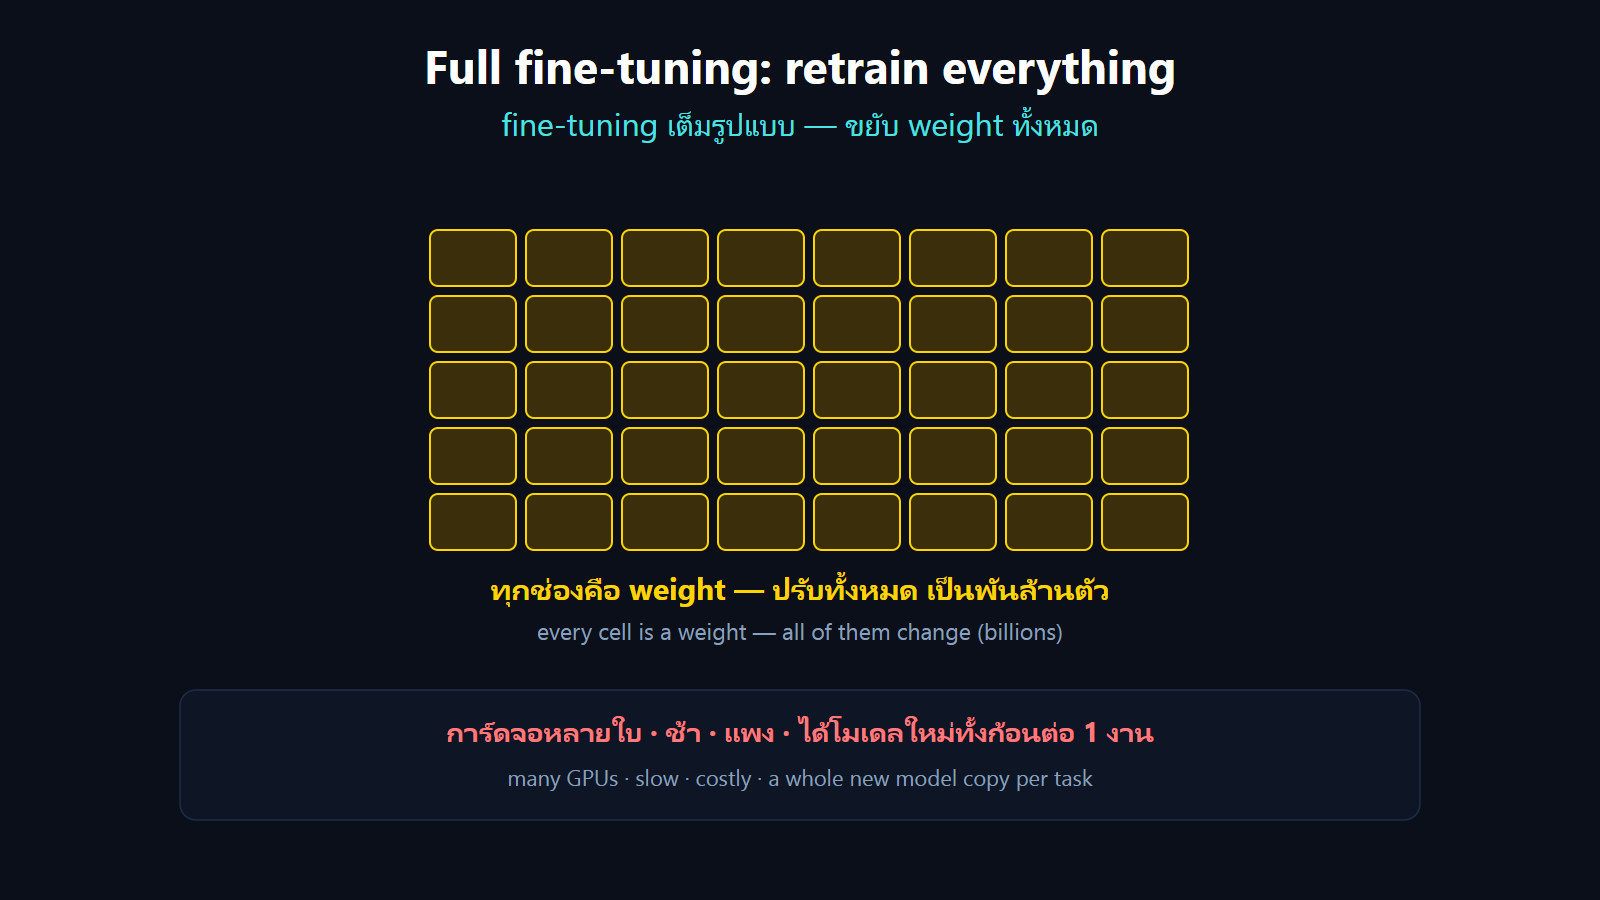
fine-tuning แบบดั้งเดิม เราต้องปรับค่าน้ำหนัก หรือ weight ทั้งหมดในโมเดลค่ะ ซึ่งโมเดลสมัยนี้มี weight เป็นพันล้านตัว การจะขยับมันทั้งหมด ต้องใช้การ์ดจอแรงๆ หลายใบ ใช้เวลานาน และใช้เงินเยอะมาก แถมพอฝึกเสร็จ เราก็ได้โมเดลยักษ์ก้อนใหม่ทั้งก้อน ที่ต้องเก็บแยกอีกต่างหาก ลองนึกภาพว่าทุกครั้งที่อยากสอนเรื่องใหม่ เราต้องสร้างโมเดลใหม่ทั้งก้อน พื้นที่เก็บกับค่าใช้จ่ายก็บานปลายเลยค่ะ แล้วลองคิดดูนะคะ ถ้าเป็นโรงเรียน หรือร้านเล็กๆ ที่อยากปรับ AI ให้เข้ากับงานหลายๆ แบบ จะต้องลงทุนขนาดไหน แทบเป็นไปไม่ได้เลยใช่ไหมคะ
เพราะแบบนี้ การ fine-tune เต็มรูปแบบ จึงเป็นเรื่องของบริษัทใหญ่ ที่มีเครื่องแรงๆ เท่านั้นค่ะ คนทั่วไป โรงเรียน หรือธุรกิจเล็กๆ แทบจะทำเองไม่ไหวเลย ทั้งเรื่องเงินและเครื่องมือ คำถามคือ เราจะสอน AI ให้เป็นของเรา โดยไม่ต้องแบกของหนักขนาดนั้นได้ไหม คำตอบอยู่ที่เทคนิคต่อไปค่ะ
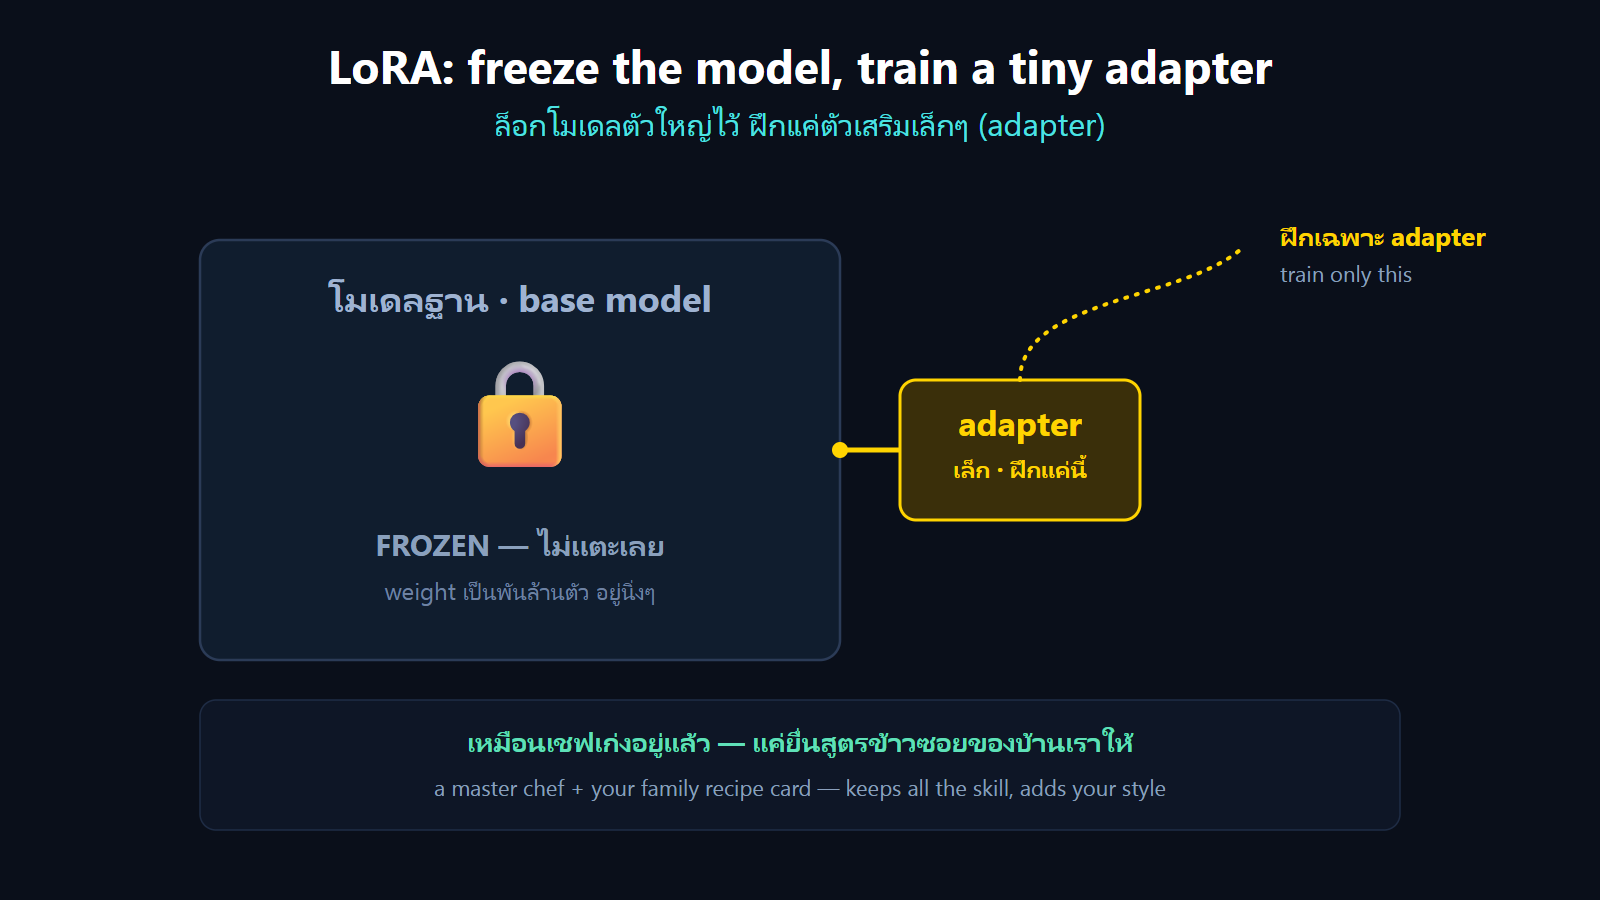
LoRA ย่อมาจาก Low-Rank Adaptation ค่ะ ไอเดียคือ เราล็อกโมเดลตัวใหญ่เอาไว้ ไม่แตะค่าเดิมเลยสักนิด แล้วแปะตัวเสริมเล็กๆ ที่เรียกว่า adapter เพิ่มเข้าไป จากนั้นเราฝึกเฉพาะเจ้าตัวเสริมเล็กๆ นี้ กับข้อมูลของเราเท่านั้น เหมือนเชฟที่ทำอาหารเก่งอยู่แล้วค่ะ เราไม่ต้องสอนเขาทำอาหารใหม่ตั้งแต่ต้น แค่ยื่นสูตรข้าวซอยของบ้านเราให้ เขาก็ทำเมนูแบบของเราได้เลย เก็บฝีมือเดิมไว้ครบ แต่เพิ่มความเป็นเราเข้าไป ที่มันเวิร์ก เพราะการสอนงานใหม่ๆ จริงๆ แล้วต้องการการปรับแค่เล็กน้อย ไม่ได้ต้องรื้อทั้งโมเดล adapter เล็กๆ จึงเก็บการเปลี่ยนแปลงที่จำเป็นได้ครบ โดยไม่ต้องไปแตะ weight เป็นพันล้านตัวเลยค่ะ
ข้อดีคือตัว adapter เล็กมากค่ะ จากโมเดลหลายกิกะไบต์ ตัวเสริมเหลือแค่ไม่กี่เมกะไบต์ เลยฝึกได้เร็ว ใช้เงินน้อย และใช้การ์ดจอแค่ใบเดียวก็พอ ไม่ต้องมีฟาร์มเซิร์ฟเวอร์ งานที่เคยเป็นของบริษัทใหญ่ ก็มาอยู่ในมือคนตัวเล็กได้ค่ะ
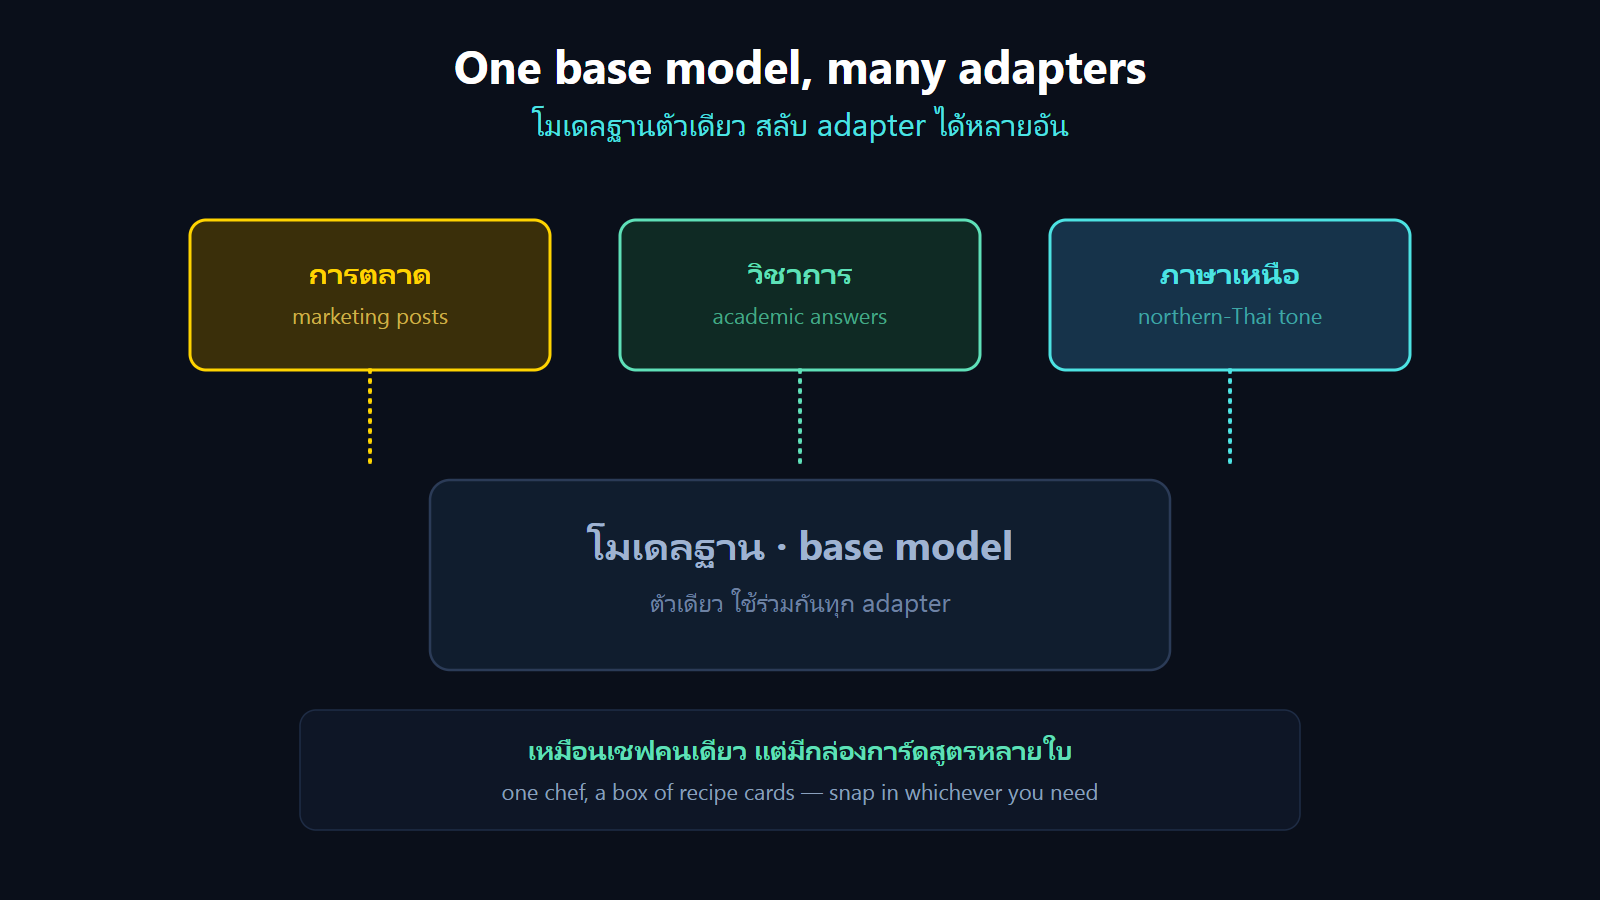
และที่เจ๋งสุดคือ เราเก็บ adapter ไว้ได้หลายๆ อันค่ะ อันหนึ่งสำหรับเขียนโพสต์การตลาด อันหนึ่งสำหรับตอบคำถามวิชาการ อีกอันสำหรับสำนวนภาษาเหนือ ทั้งหมดนี้ใช้โมเดลฐานตัวเดียวกัน แล้วสลับแปะ adapter ไปมาได้เลย เหมือนมีเชฟคนเดียว แต่มีกล่องการ์ดสูตรอาหารหลายใบ อยากได้เมนูไหนก็หยิบการ์ดใบนั้นมาเสียบ ประหยัดทั้งพื้นที่เก็บและเวลาค่ะ
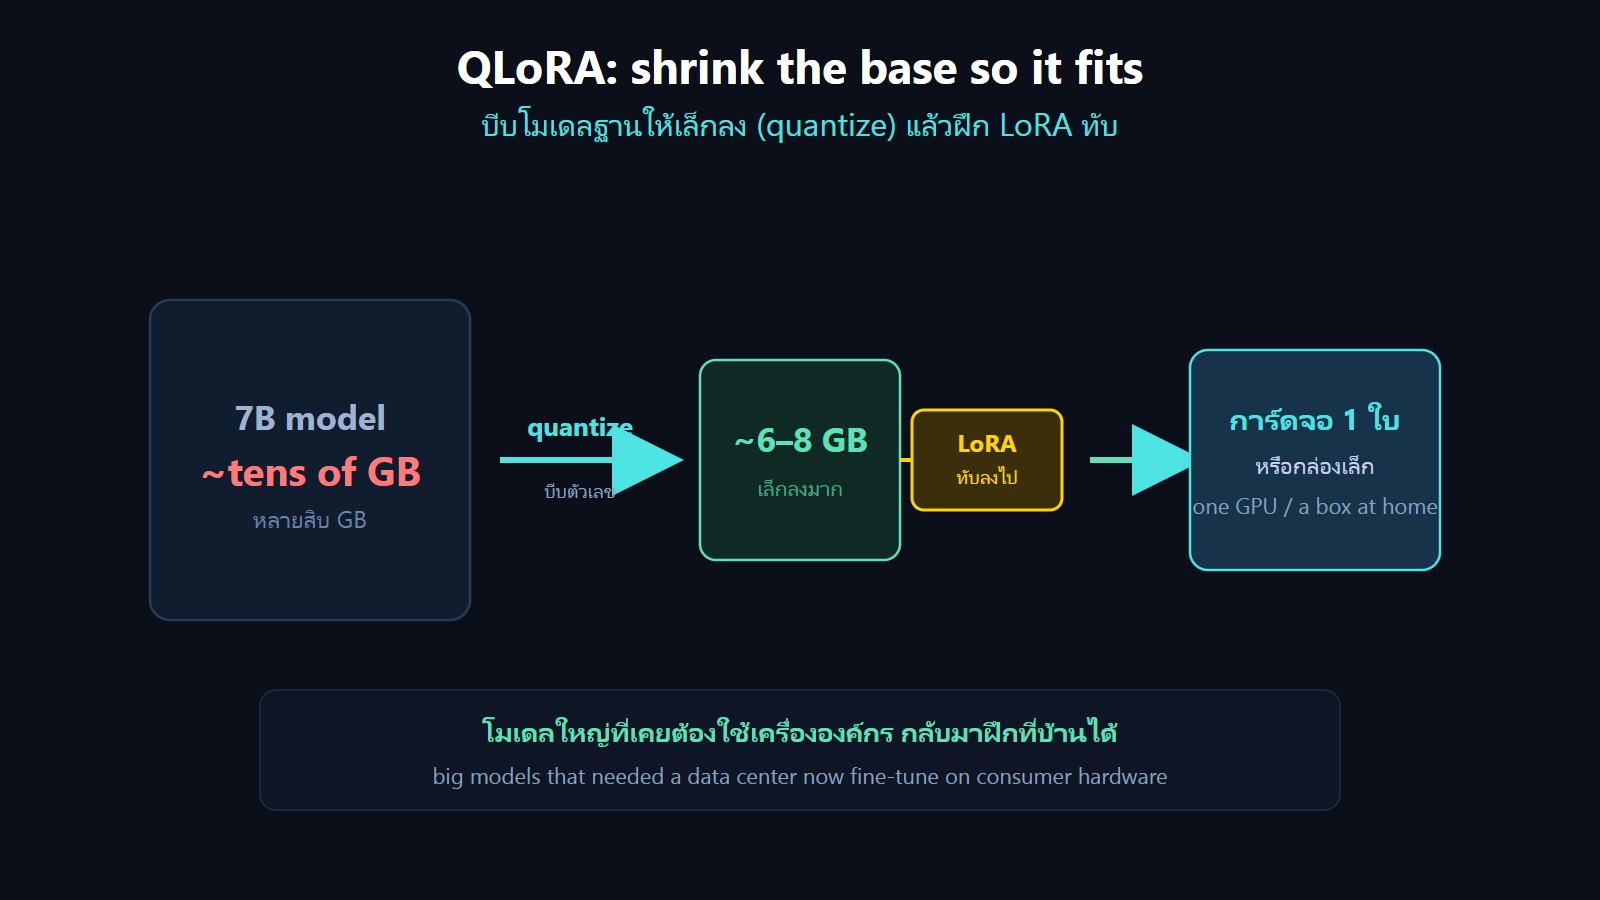
มีอีกเทคนิคที่ช่วยให้ประหยัดกว่าเดิมอีก ชื่อว่า QLoRA ค่ะ ปกติโมเดลใหญ่เก็บตัวเลขแบบละเอียดมาก กินหน่วยความจำเยอะ QLoRA จะบีบตัวเลขของโมเดลฐานให้เล็กลง หรือที่เรียกว่า quantize ให้เหลือความละเอียดแค่พอใช้ แล้วค่อยฝึก LoRA ทับลงไป ยกตัวอย่างคร่าวๆ นะคะ โมเดลขนาดเจ็ดพันล้านพารามิเตอร์ ปกติกินหน่วยความจำหลายสิบกิกะไบต์ พอ quantize ลงมา อาจเหลือราวๆ หกถึงแปดกิกะไบต์ ลงการ์ดจอทั่วๆ ไป หรือกล่องเล็กๆ ที่บ้านได้สบายเลยค่ะ
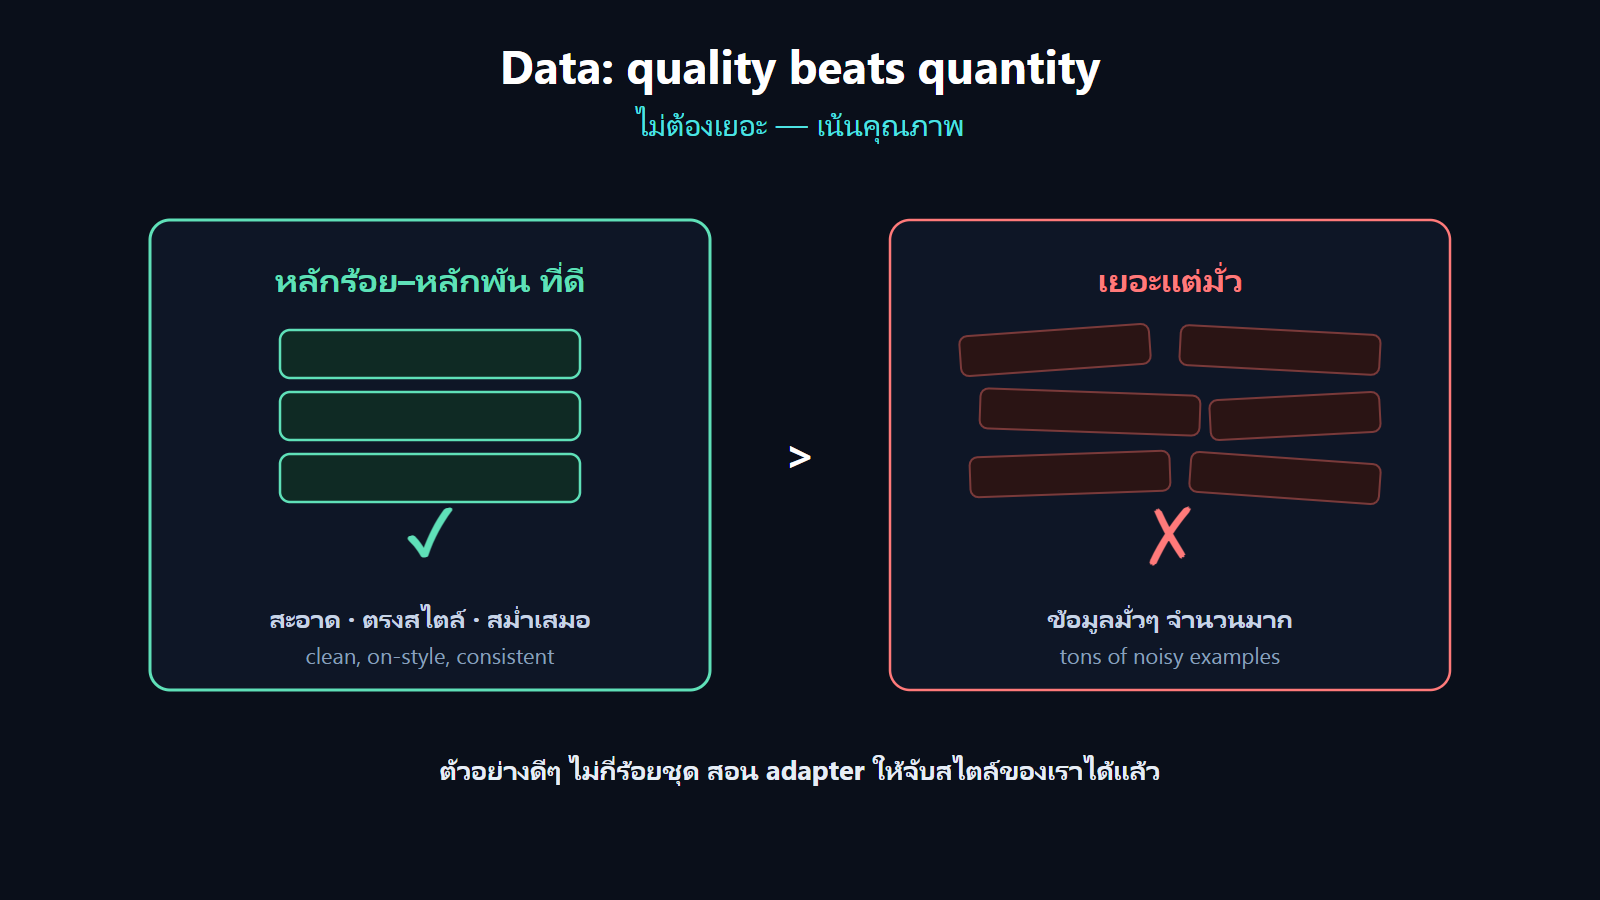
แล้วต้องใช้ข้อมูลเยอะไหมคะ ข่าวดีคือ ไม่ต้องเยอะอย่างที่หลายคนคิดเลย สิ่งที่สำคัญกว่าปริมาณ คือคุณภาพค่ะ ตัวอย่างที่ดี และตรงกับสไตล์ที่เราต้องการ แค่หลักร้อยถึงหลักพันชุด ก็สอน adapter ให้จับสไตล์ของเราได้แล้ว ขอแค่ข้อมูลสะอาด สม่ำเสมอ และเป็นแบบที่เราอยากให้ AI ตอบจริงๆ ผลที่ได้จะดีกว่าการเทข้อมูลมั่วๆ จำนวนมากค่ะ
และเพราะ LoRA กับ QLoRA ฝึกบนเครื่องของเราเองได้ ข้อมูลก็ไม่ต้องส่งออกไปให้บริษัทไหนเลยค่ะ จุดนี้สำคัญมากสำหรับโรงเรียน โรงพยาบาล หรือองค์กรที่ข้อมูลเป็นความลับ เราปรับแต่ง AI ให้เป็นของเรา บนกล่องเล็กๆ ที่ตั้งอยู่ในห้องเราเอง แล้วข้อมูลนักเรียนหรือลูกค้า ก็อยู่กับเราตลอด ไม่รั่วไปไหนค่ะ
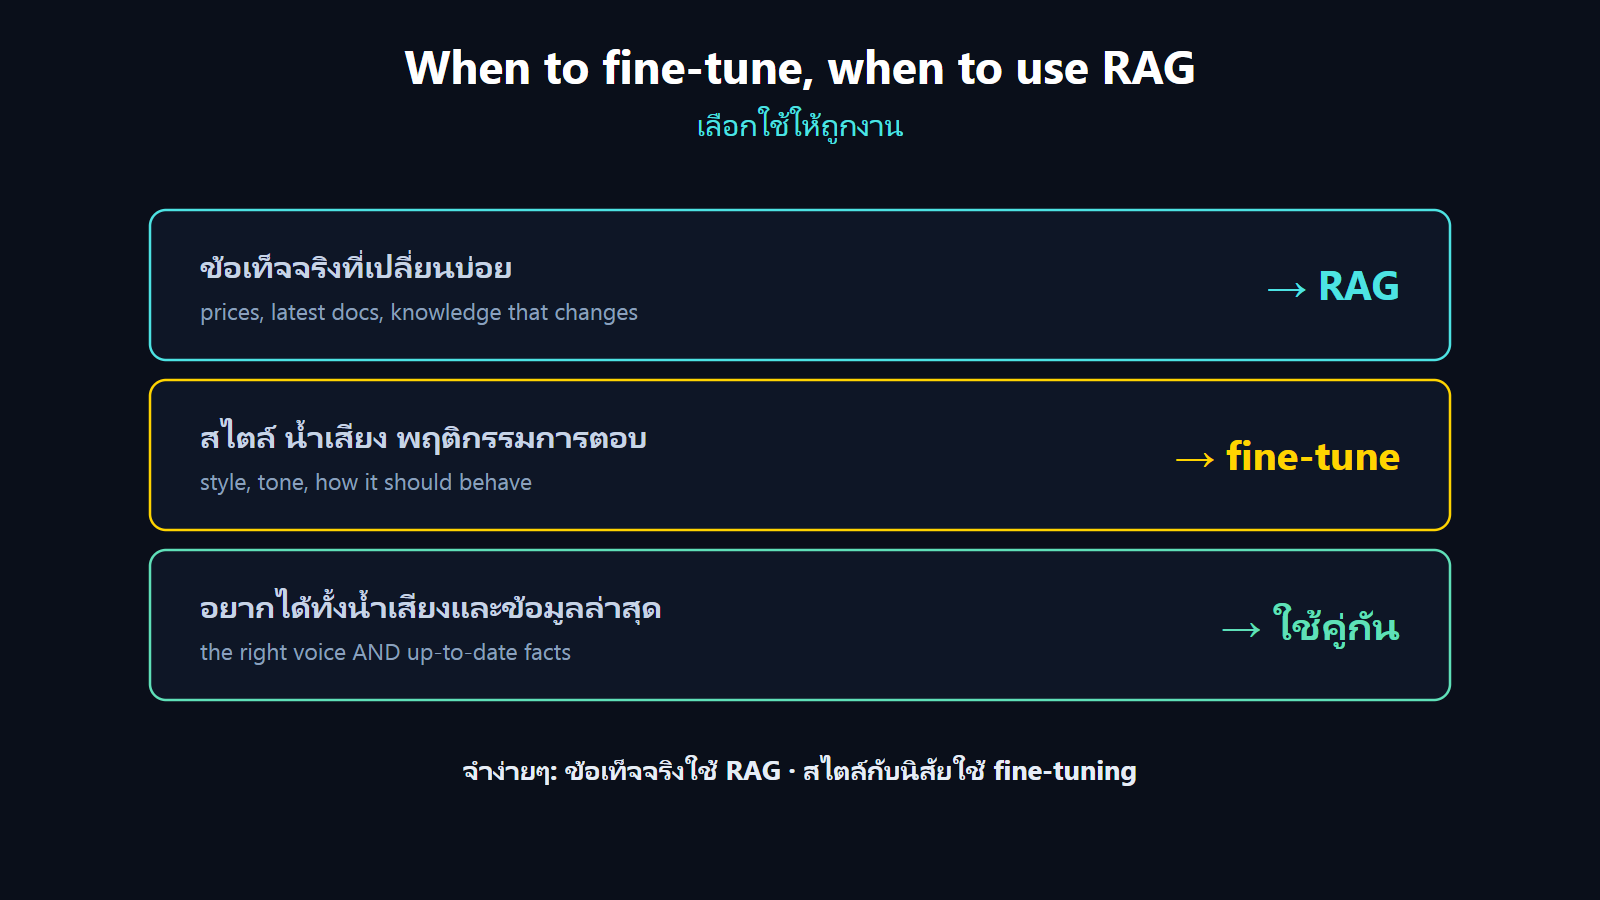
แต่ fine-tuning ไม่ใช่คำตอบของทุกอย่างนะคะ ถ้าเราแค่อยากให้ AI รู้ข้อเท็จจริงใหม่ๆ ที่เปลี่ยนบ่อย เช่น ราคาสินค้า หรือเอกสารล่าสุด ใช้วิธี RAG คือให้มันไปค้นเอกสารตอนตอบ จะง่ายและถูกกว่าค่ะ เราจะเลือก fine-tuning ก็ต่อเมื่ออยากเปลี่ยนพฤติกรรม สไตล์ หรือรูปแบบการตอบ ให้มันติดตัวโมเดลไปเลย จำง่ายๆ ค่ะ ข้อเท็จจริงใช้ RAG สไตล์กับนิสัยใช้ fine-tuning และจริงๆ เราใช้สองอย่างพร้อมกันก็ได้นะคะ fine-tune ให้ได้น้ำเสียงที่ใช่ แล้วเสริม RAG ให้รู้ข้อมูลล่าสุด ก็จะได้ผู้ช่วยที่ทั้งพูดเป็นแบบเรา และตอบตรงข้อมูลค่ะ
ยกตัวอย่างจริงนะคะ สมมติโรงเรียนเราอยากได้ผู้ช่วย AI ที่ตอบนักเรียนด้วยน้ำเสียงอ่อนโยนแบบครู และใช้คำอธิบายสไตล์ของโรงเรียนเรา เราก็รวบรวมตัวอย่างบทสนทนาดีๆ สักชุดหนึ่ง เอามาฝึกเป็น adapter ด้วย LoRA ไม่กี่ชั่วโมงบนเครื่องเล็กๆ เราก็ได้ผู้ช่วยที่พูดจาเป็นแบบของเราเอง โดยไม่ต้องจ่ายค่าเทรนโมเดลทั้งตัว และไม่ต้องส่งข้อมูลออกไปไหนค่ะ หรืออีกตัวอย่าง ร้านค้าออนไลน์ อยากให้ AI ตอบแชตลูกค้า ด้วยน้ำเสียงเป็นกันเองแบบร้านเรา ก็เอาแชตเก่าๆ ที่ตอบได้ดี มาฝึกเป็น adapter ได้เหมือนกันค่ะ
แล้วถ้าจะเริ่มเอง ต้องมีอะไรบ้างคะ หลักๆ มีสามอย่าง หนึ่ง โมเดลฐานแบบเปิด ที่โหลดมาใช้ฟรีได้ เช่นตระกูล Llama หรือ Qwen สอง ชุดข้อมูลตัวอย่างของเรา ยิ่งคุณภาพดี ผลยิ่งดีค่ะ และสาม เครื่องมือสำหรับฝึก LoRA ที่มีคนทำไว้ให้ใช้ฟรี กับการ์ดจอสักตัว หรือกล่อง AI เล็กๆ สักเครื่อง เท่านี้ก็เริ่มได้แล้วค่ะ
สรุปทั้งหมดนะคะ การสอน AI ด้วยข้อมูลของเราเอง ทำได้โดยไม่ต้องฝึกโมเดลทั้งตัว LoRA ให้เราล็อกโมเดลเดิมไว้ แล้วฝึกแค่ adapter เล็กๆ ที่ประหยัดและเร็ว QLoRA ช่วยให้มันลงเครื่องเล็กได้ เก็บได้หลาย adapter สลับใช้ได้ เลือก fine-tuning สำหรับสไตล์ และ RAG สำหรับข้อเท็จจริง และที่สำคัญ ทำเองที่บ้านได้ ข้อมูลอยู่กับเราตลอดค่ะ
ตอนหน้า ครูนารีจะลงมือ ฝึก AI ตัวจริงให้ดู แบบทีละขั้น บนกล่อง AI ที่บ้านเลยค่ะ ใครไม่อยากพลาด กดติดตามไว้ได้เลยนะคะ และใครอยากฝึกภาษาอังกฤษไปกับ AI ทุกวัน แอดไลน์ครูนารีไว้ได้เลยค่ะ เจอกันในบทเรียนต่อไปบนไลน์นะคะ
เรียน AI ตั้งแต่ศูนย์ ไปด้วยกันนะคะ
ดูทั้งซีรีส์ How Machines Learn บน YouTube — ฟรีทุกตอนค่ะ