How does ChatGPT actually work? The whole story in one video — how a model that only predicts the next word becomes a helpful assistant, in three steps.
ChatGPT ทำงานยังไง — จากเครื่องทายคำ สู่ผู้ช่วยที่ตอบได้ถูกใจ จบในคลิปเดียวค่ะ
📑 ช่วงเวลา / Chapters
- 0:00 — How ChatGPT works in 3 steps · ChatGPT ทำงานยังไง ใน 3 ขั้นตอน
- 2:01 — Pretraining: reading the internet · การฝึกตั้งต้น
- 3:39 — How does ChatGPT learn to follow instructions? · ChatGPT เรียนทำตามคำสั่งได้ยังไง
- 5:38 — Why does ChatGPT give answers you actually like? · ทำไม ChatGPT ตอบได้ถูกใจเรา
How ChatGPT works in 3 steps
ChatGPT ทำงานยังไง ใน 3 ขั้นตอน
ChatGPT พิมพ์อะไรไปก็ตอบได้เหมือนคนจริงๆ แต่ลึกๆ แล้ว มันเป็นแค่เครื่องทายคำถัดไปเท่านั้นเองค่ะ แล้วเครื่องทายคำธรรมดาๆ กลายมาเป็นผู้ช่วยที่ฉลาดได้ยังไงคะ ครูนารีค่ะ วันนี้เราจะเล่า ทั้งเรื่องในคลิปเดียว แบ่งเป็นสามขั้นตอนค่ะ
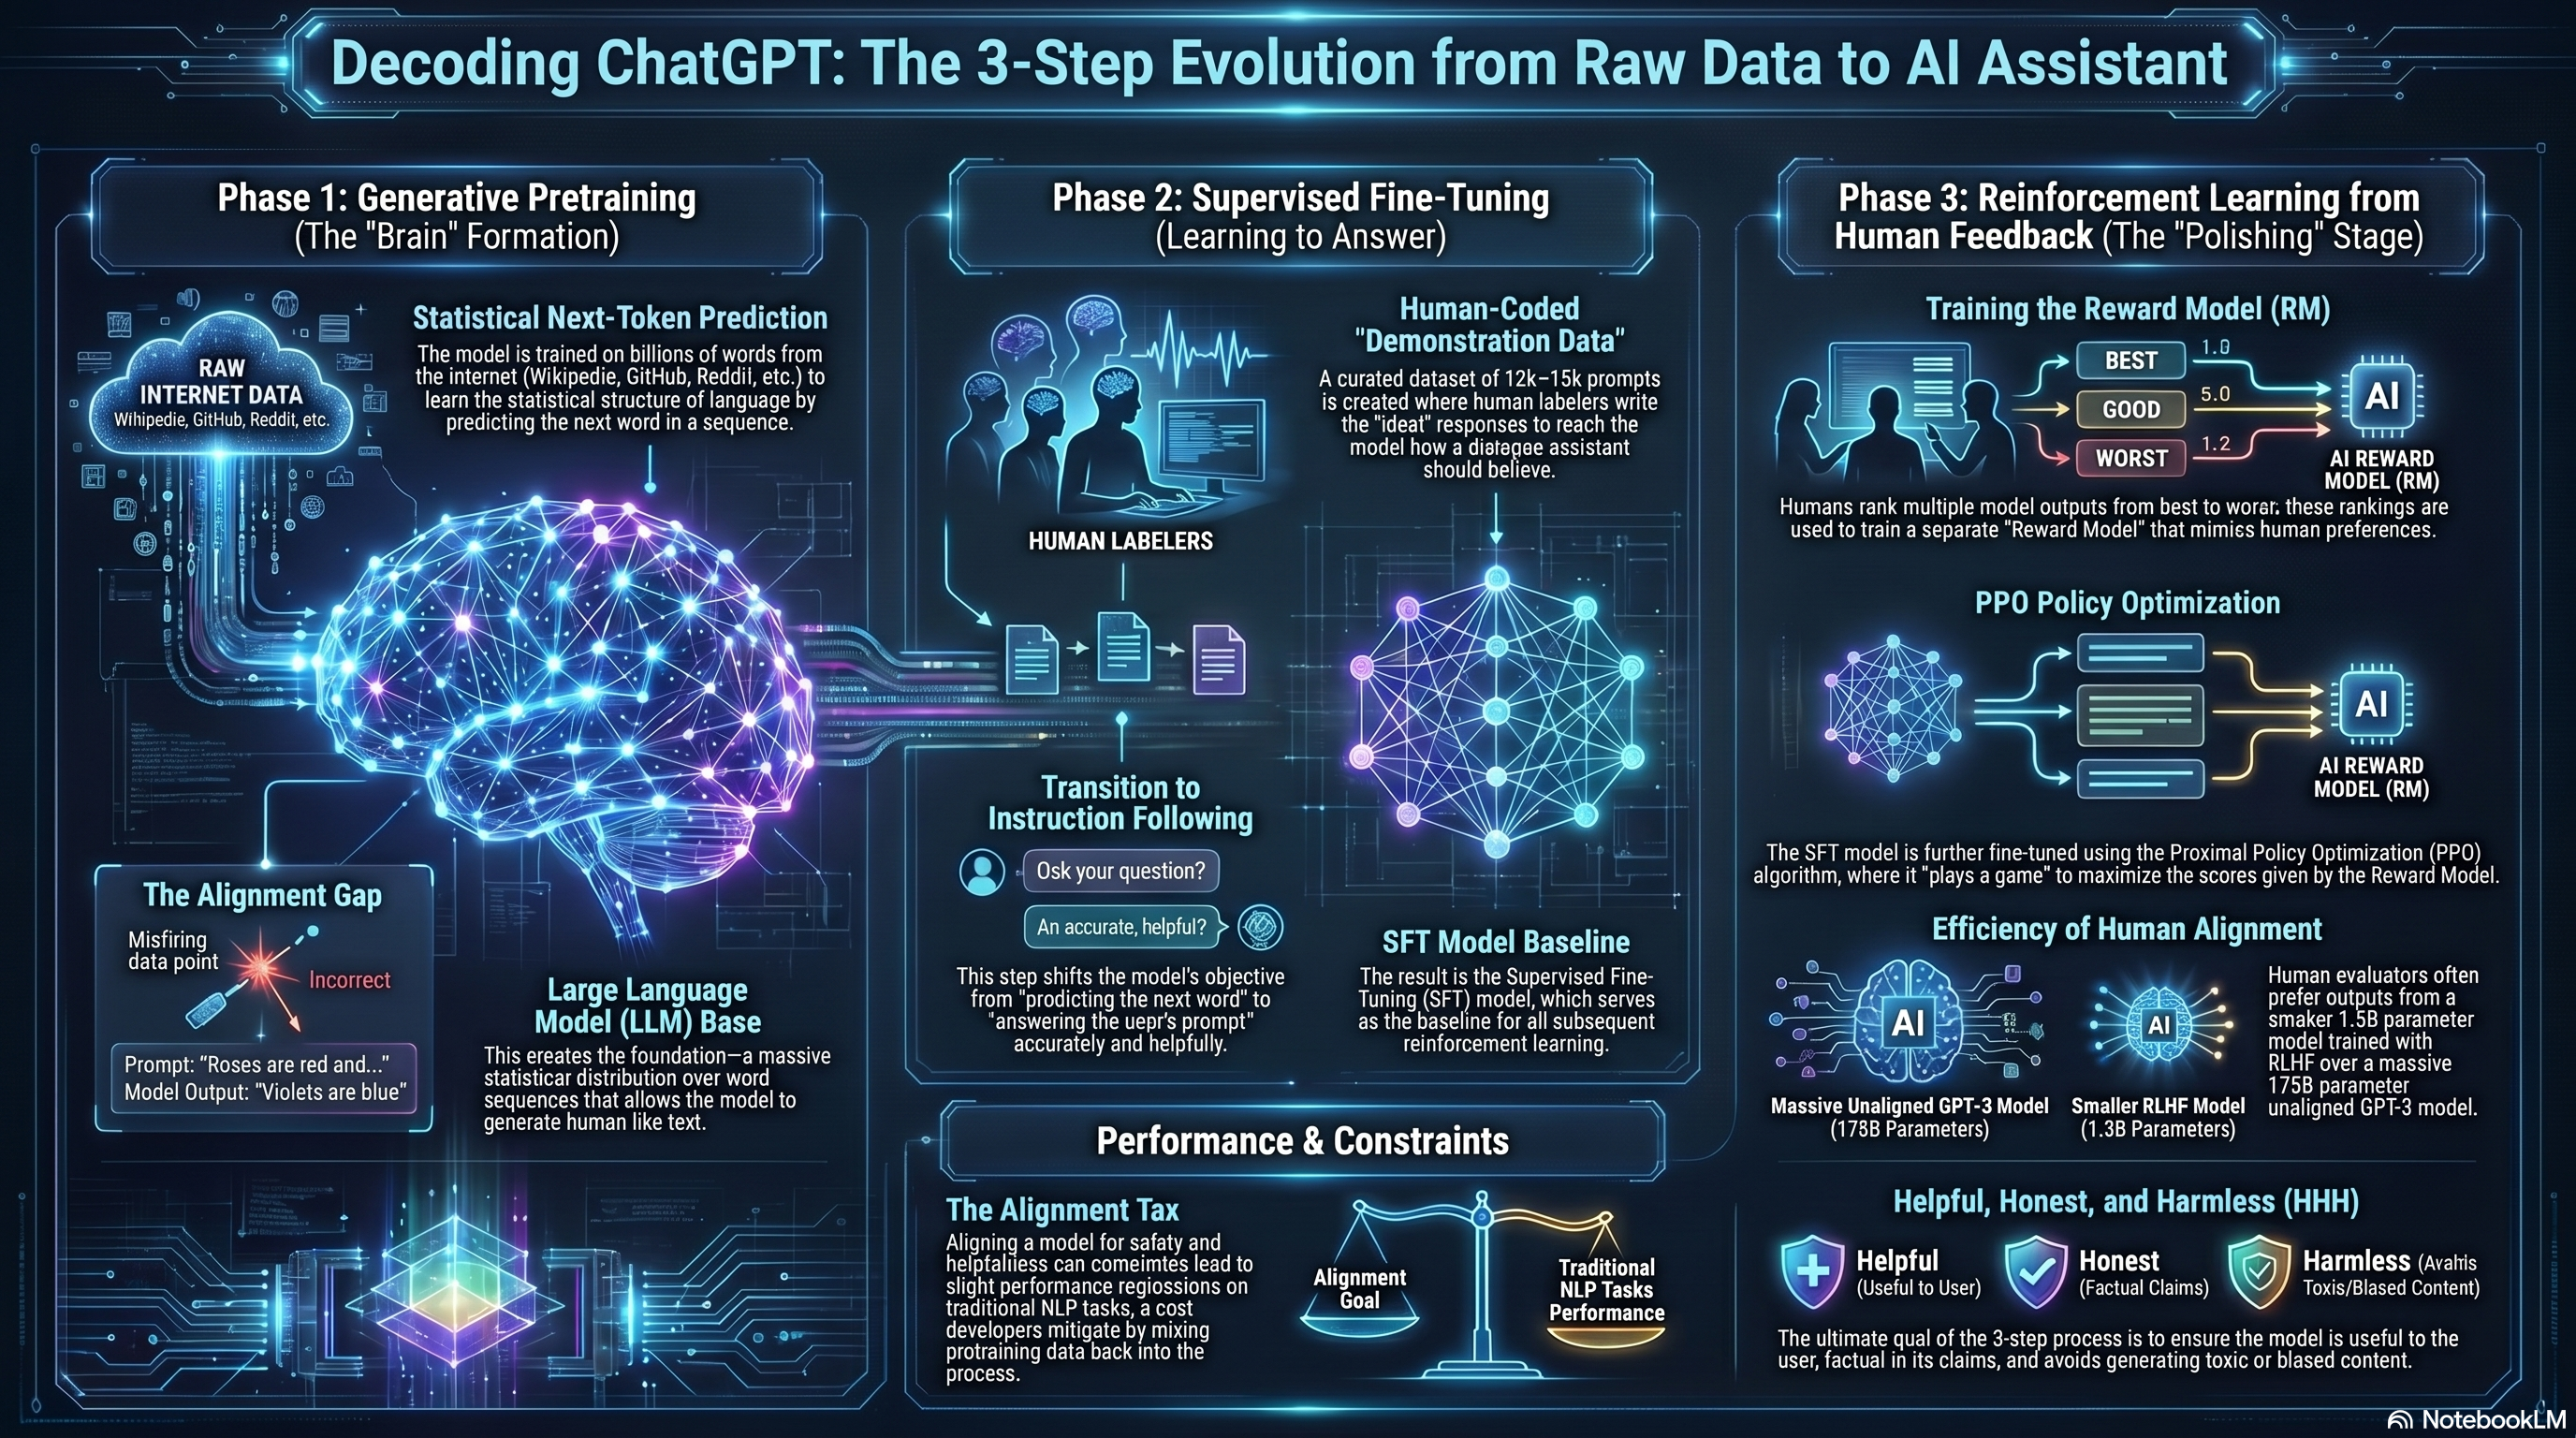
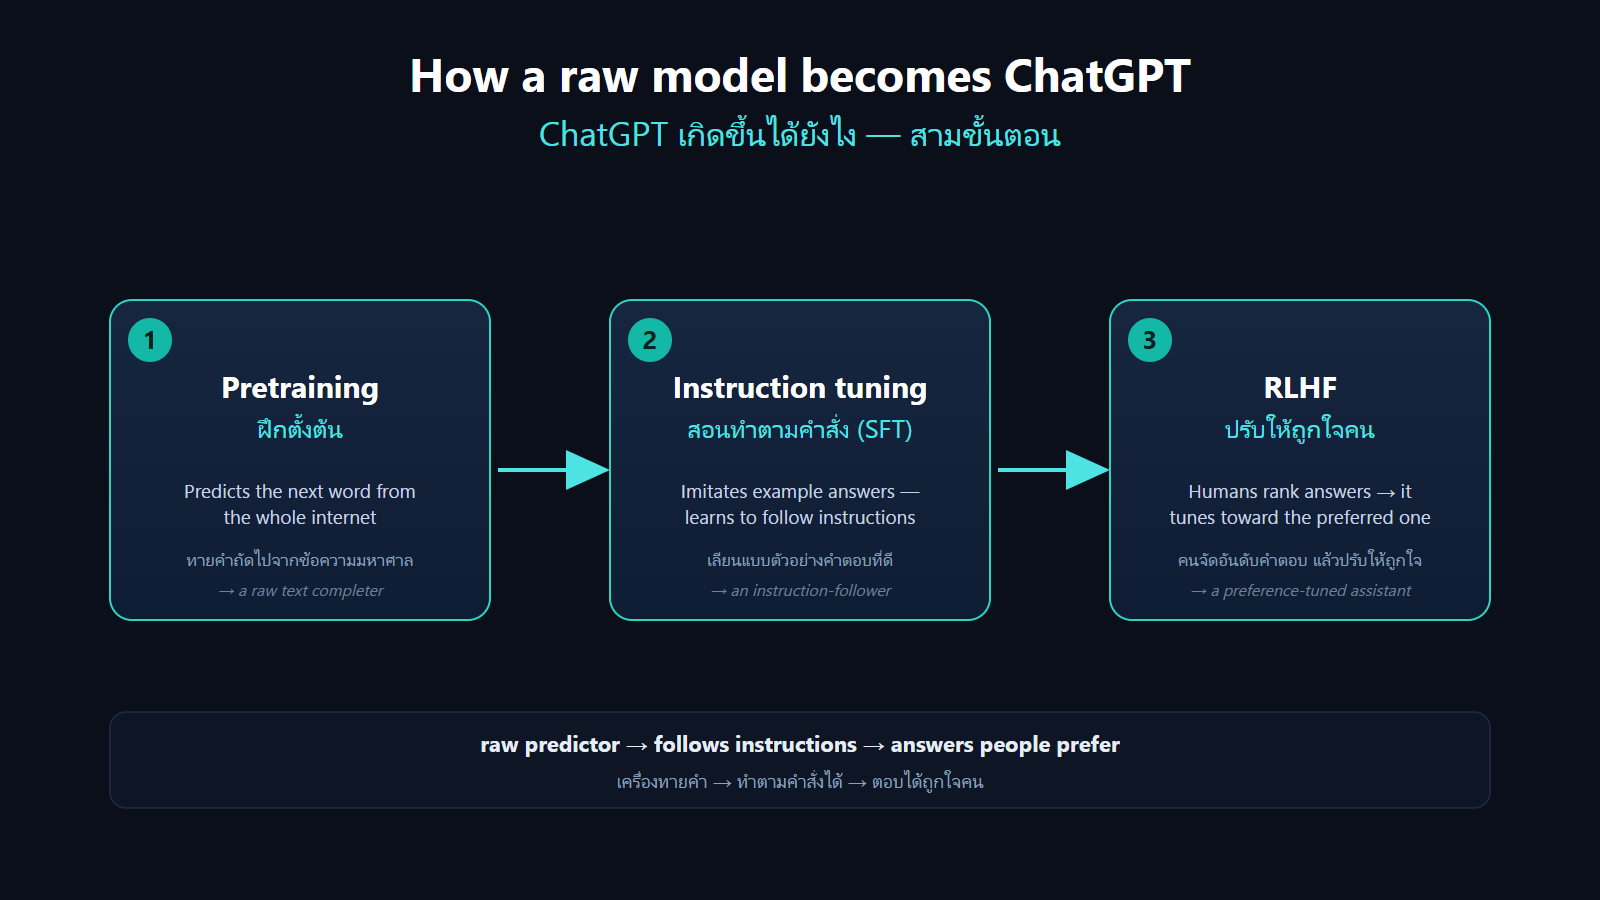
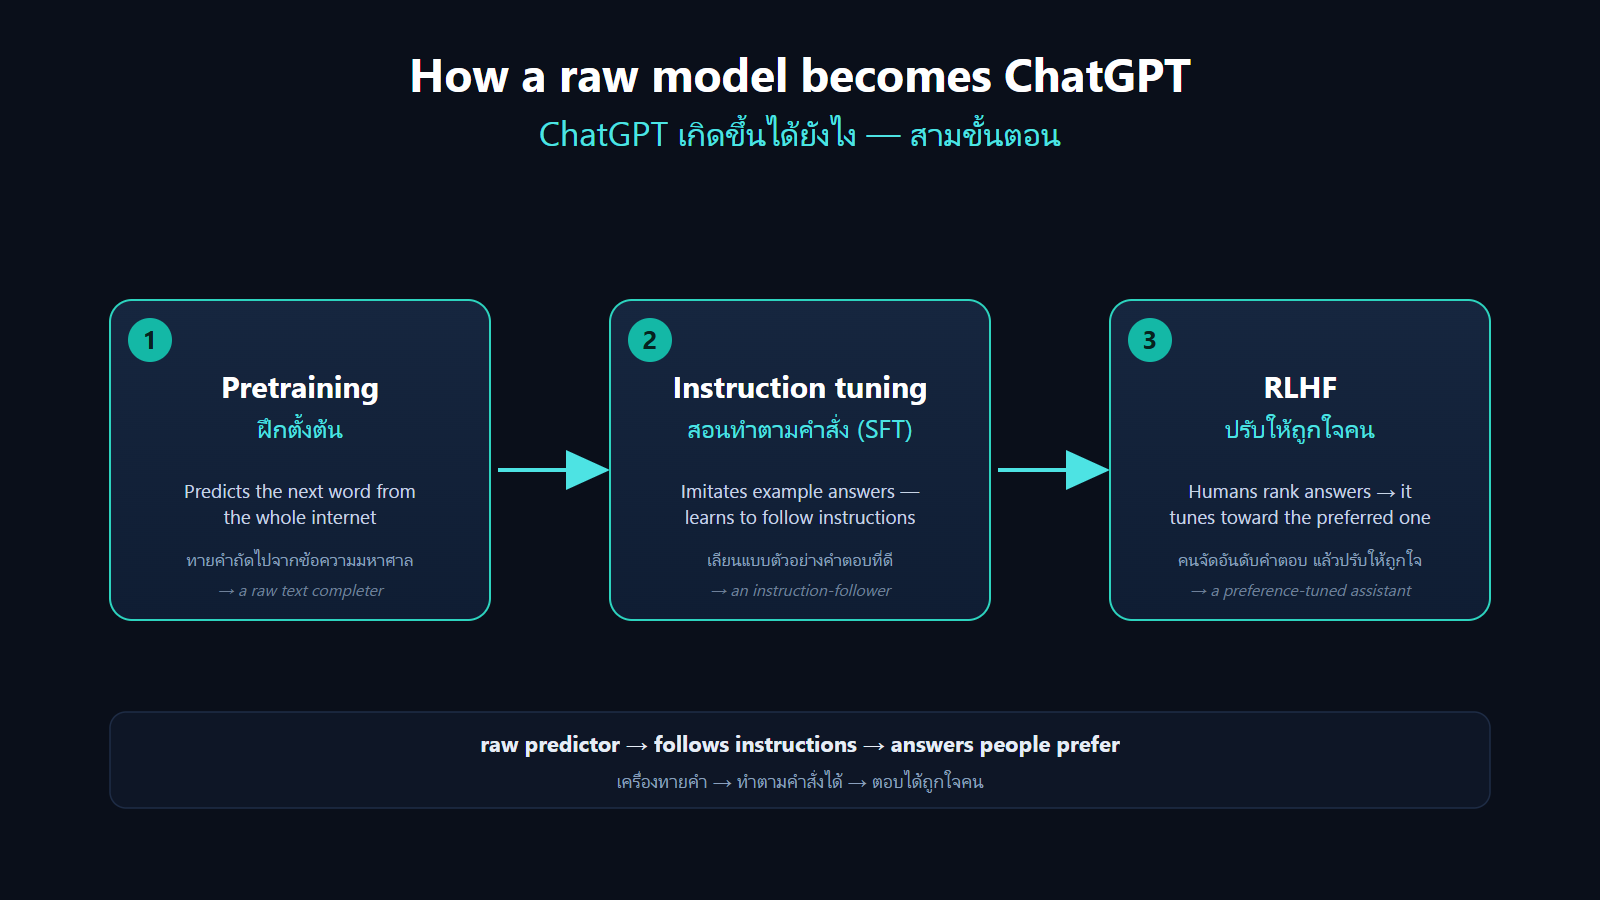
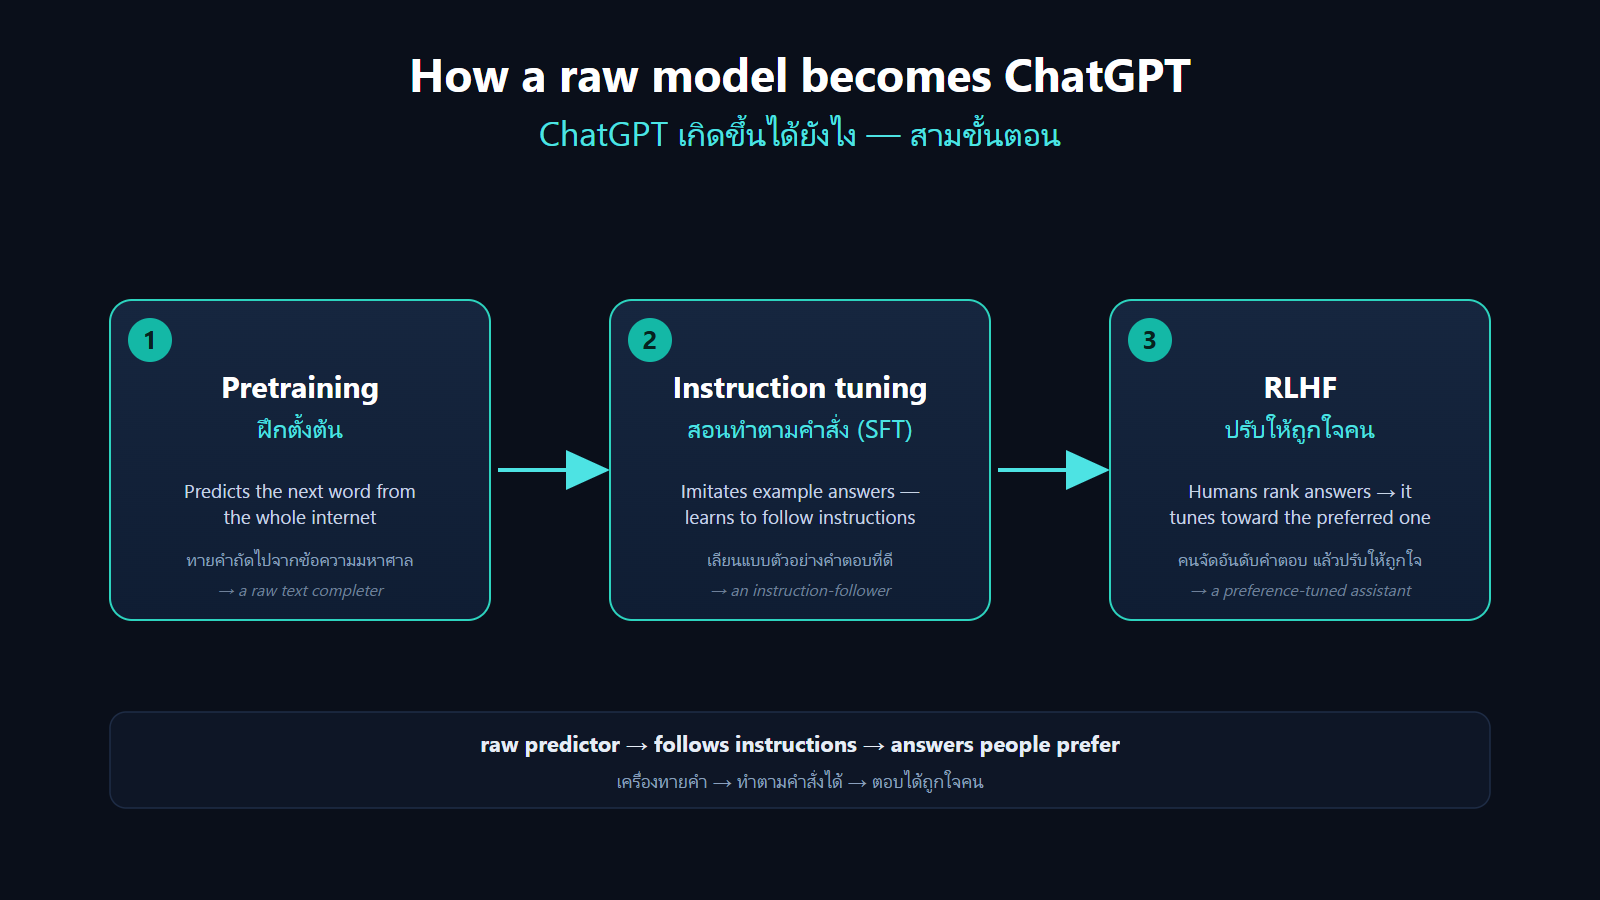
การสร้าง ChatGPT มีสามขั้นใหญ่ๆ ค่ะ ขั้นที่หนึ่งคือ pretraining ขั้นที่สอง สอนให้ทำตามคำสั่ง หรือ SFT และขั้นที่สาม ปรับให้ตอบได้ถูกใจคน หรือ RLHF เดี๋ยวเราไล่ดูทีละขั้นค่ะ
ขั้นแรก pretraining เป็นที่มาของความรู้ทั้งหมดค่ะ โมเดลอ่านข้อความมหาศาลทั้งอินเทอร์เน็ต แล้วฝึกอย่างเดียวเลย คือทายคำถัดไป ทายผิดก็ปรับตัวเองนิดนึง ทำซ้ำเป็นล้านล้านครั้ง จนรู้เรื่องโลกเยอะมาก แต่ตอนนี้มันยังเป็นแค่เครื่องเติมข้อความ ยังไม่ใช่ผู้ช่วยนะคะ
ขั้นที่สอง เราสอนให้มันทำตามคำสั่งค่ะ ด้วยการให้ดูตัวอย่างดีๆ ที่คนเขียนขึ้น เป็นคู่ของคำสั่งกับคำตอบที่ดี มันก็เลยค่อยๆ เลียนแบบ จนตอบเป็นผู้ช่วยได้ ขั้นนี้เรียกว่า instruction tuning หรือ SFT ค่ะ
ขั้นที่สาม เราปรับให้มันตอบได้ถูกใจคนยิ่งขึ้นค่ะ โดยให้คนเปรียบเทียบว่าคำตอบไหนดีกว่ากัน แล้วโมเดลก็ฝึกให้ตอบในแบบที่คนชอบ ขั้นนี้เรียกว่า RLHF ย้ำนะคะว่าขั้นนี้ไม่ได้เพิ่ม ความรู้ใหม่ แต่ปรับสไตล์การตอบให้ถูกใจเรามากขึ้นค่ะ
สามขั้นนี้แหละค่ะ ที่เปลี่ยนเครื่องทายคำ ให้กลายเป็น ChatGPT มาเริ่มกันที่ขั้นแรกเลยดีกว่า pretraining โมเดลเรียนรู้จากอินเทอร์เน็ตได้ยังไง ไปดูกันค่ะ
Pretraining: reading the internet
การฝึกตั้งต้น
สวัสดีค่ะ นี่คือครูนารี ตอนที่แล้วเราเห็นวงจรการฝึก ทาย วัดผิด แล้วปรับ weights วันนี้เรามาดูว่าโมเดลภาษาขนาดยักษ์ อย่าง ChatGPT เขาฝึกกันยังไงค่ะ ขั้นตอนนี้เรียกว่า pretraining. หรือการฝึกตั้งต้นค่ะ
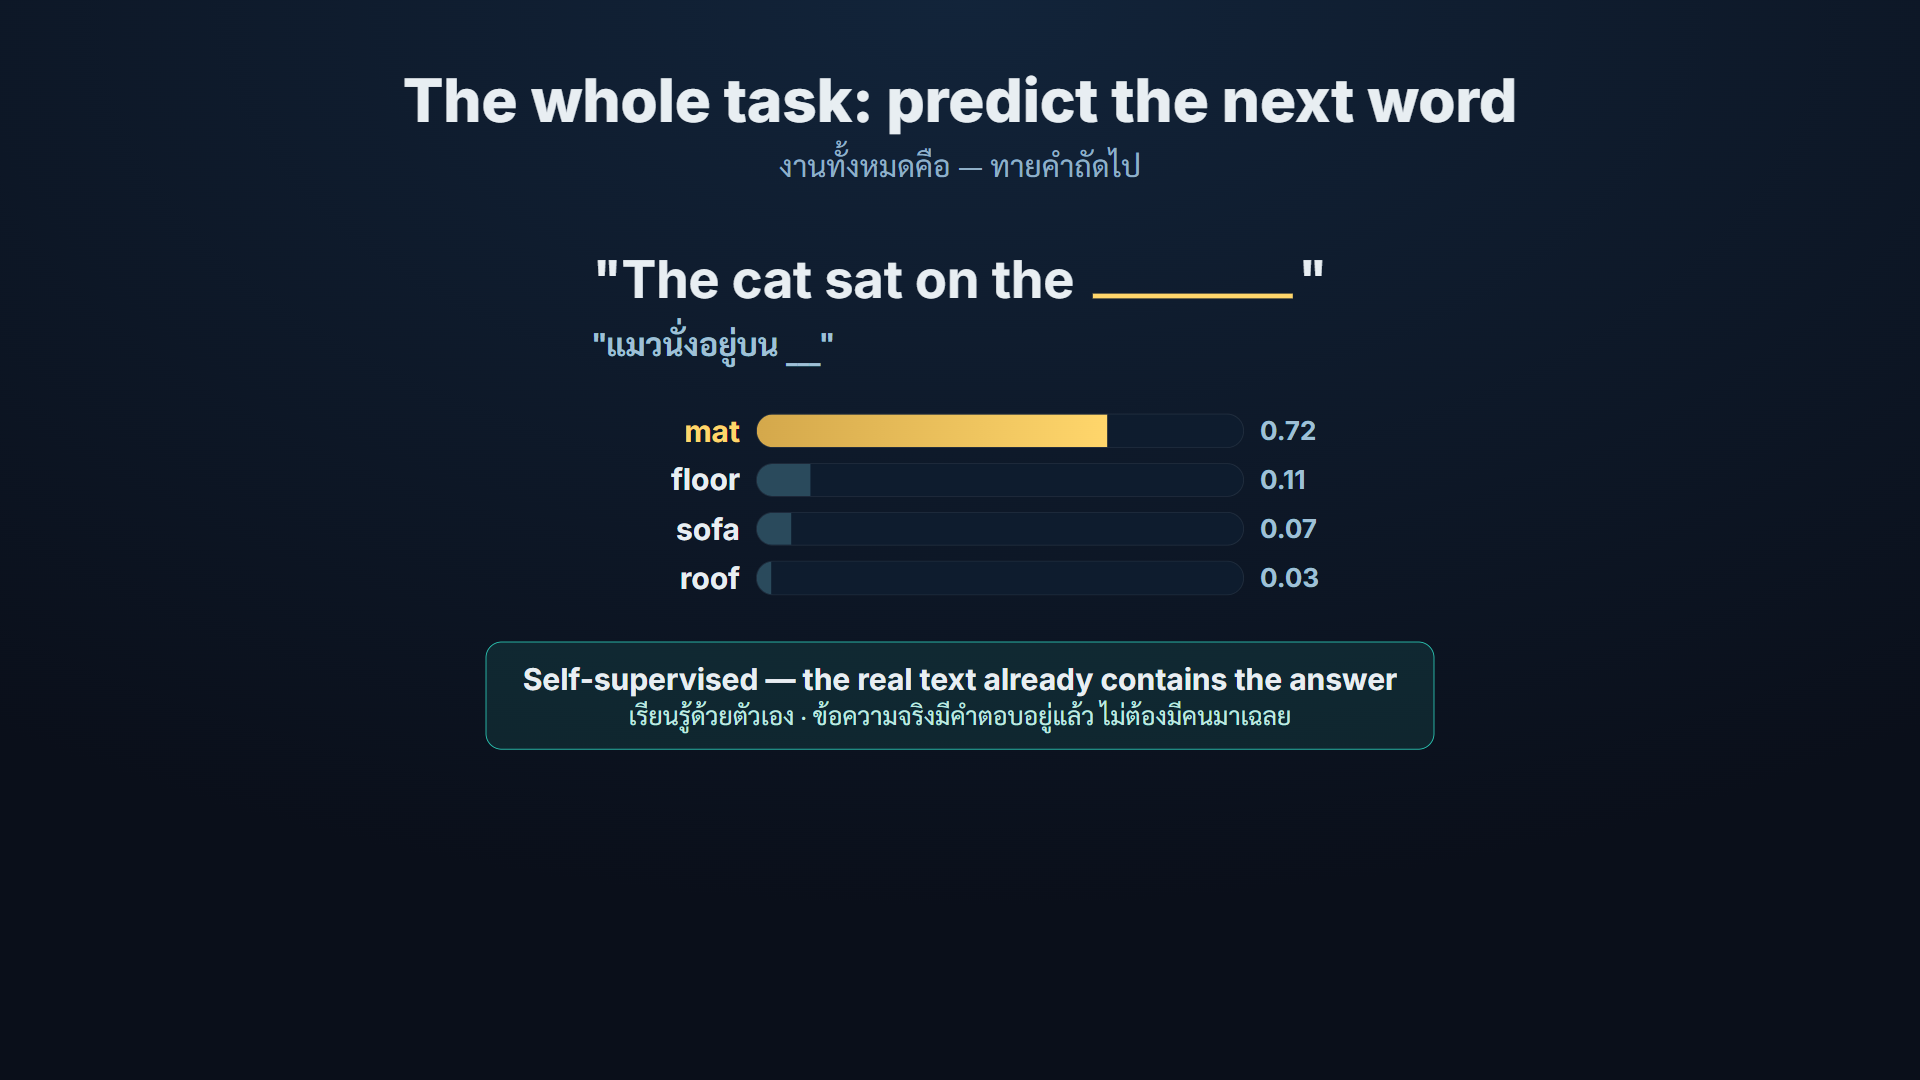
หัวใจของ pretraining ง่ายมากค่ะ แค่ทายคำถัดไป เช่น แมวนั่งอยู่บน...โมเดลต้องทายว่าคำต่อไปคืออะไร ที่เจ๋งคือเราไม่ต้องเฉลยเลย เพราะข้อความจริงมีคำตอบอยู่ในตัวแล้ว เราเรียกว่า self-supervised เรียนรู้ได้ด้วยตัวเองค่ะ
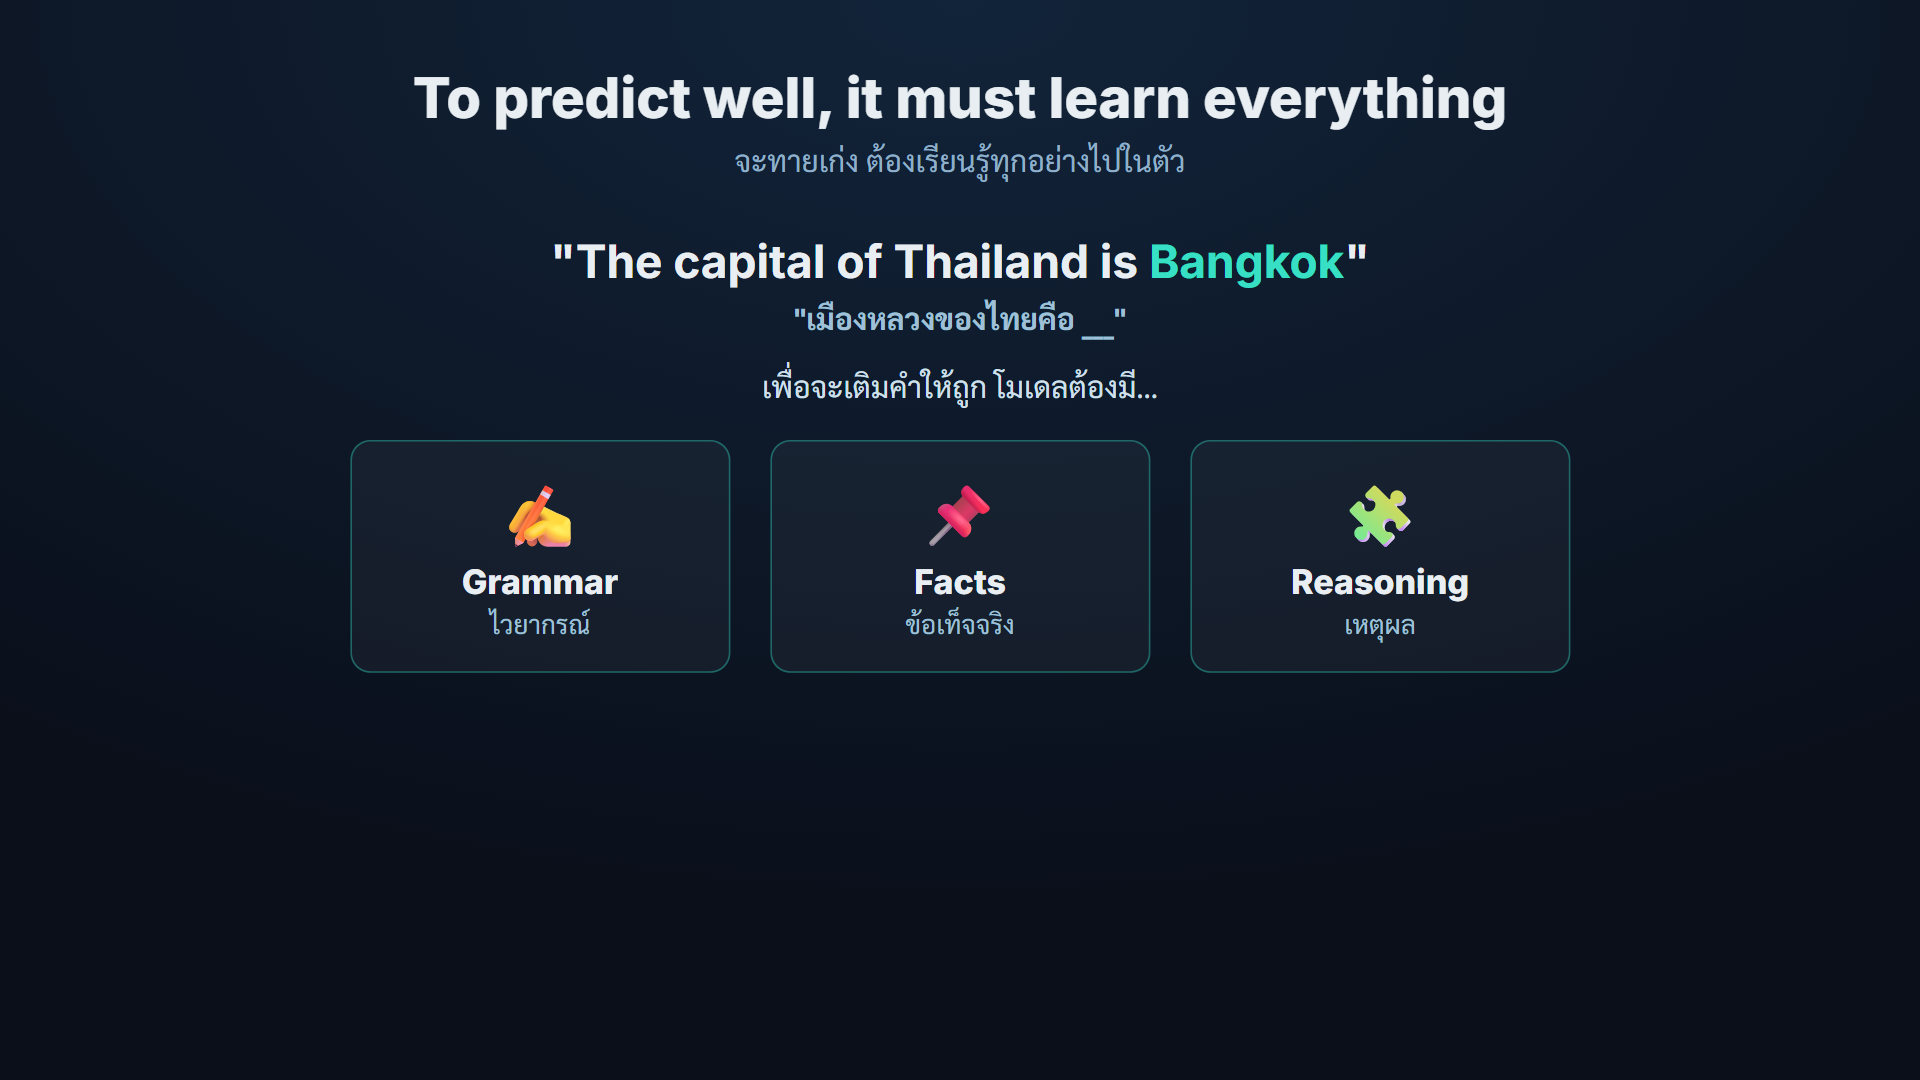
ฟังดูง่ายใช่ไหมคะ แต่การจะทายคำถัดไปได้เก่งจริงๆ โมเดลต้องเรียนไวยากรณ์ ข้อเท็จจริง และเหตุผลไปด้วย เช่น เมืองหลวงของไทยคือ...ถ้าจะทายถูก มันต้องรู้จริงๆ ว่าคือกรุงเทพ การทายคำถัดไปเลยสอนทุกอย่างไปในตัวค่ะ
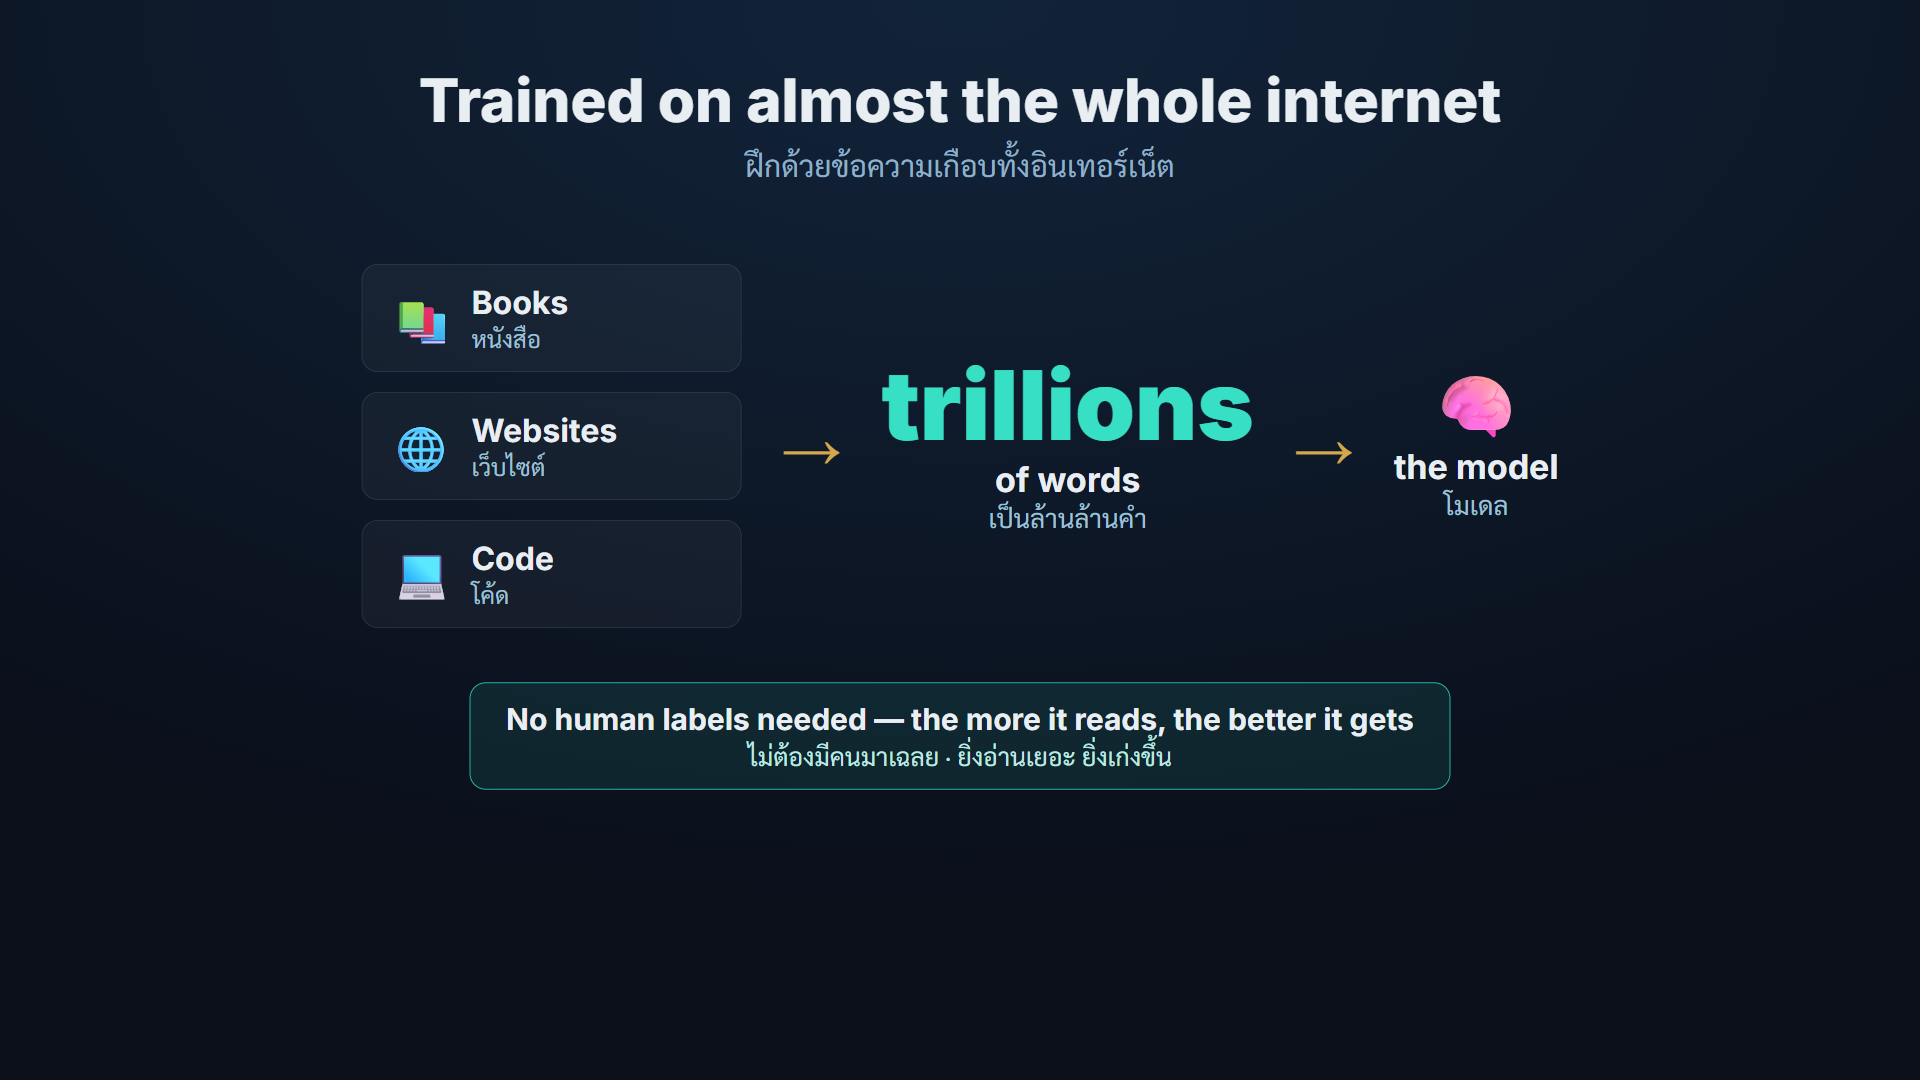
แล้วฝึกด้วยอะไรคะ ด้วยข้อความมหาศาล เป็นล้านล้านคำ ทั้งหนังสือ เว็บไซต์ และโค้ด แทบจะทั้งอินเทอร์เน็ตเลยค่ะ ยิ่งอ่านเยอะ ยิ่งจับรูปแบบของภาษาได้ดีขึ้น
ข้อมูลพวกนี้มีอยู่จริงนะคะ อย่างบนเว็บ Hugging Face มีชุดข้อมูลขนาดใหญ่มากให้ดู เป็นข้อความจากเว็บทั่วโลก เป็นพันๆ ล้านหน้า ที่เอามาใช้ฝึกโมเดลได้เลยค่ะ
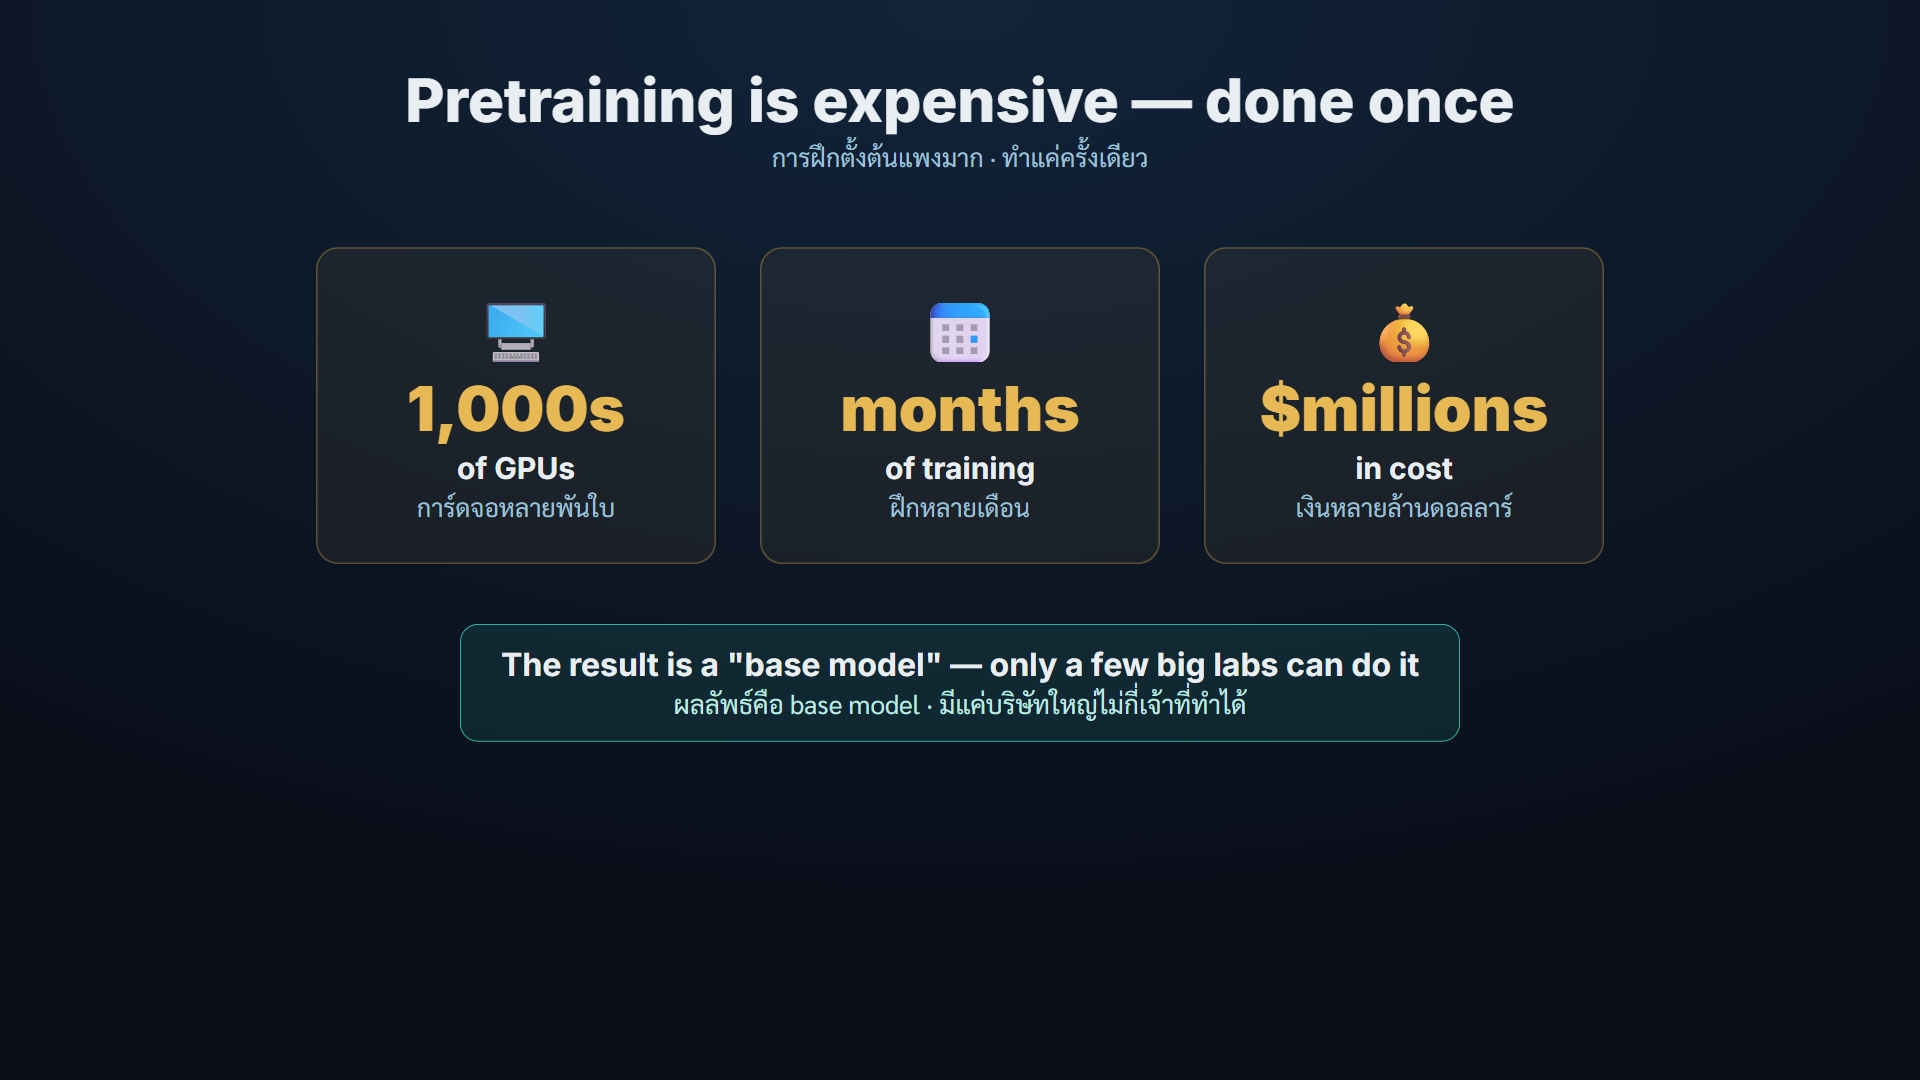
แต่ pretraining แพงมากค่ะ ต้องใช้การ์ดจอหลายพันใบ ฝึกกันหลายเดือน ใช้เงินหลายล้านดอลลาร์ เลยมีแค่บริษัทใหญ่ๆ ไม่กี่เจ้าที่ทำได้ และทำแค่ครั้งเดียว ผลลัพธ์ที่ได้เราเรียกว่า base model ค่ะ
แต่ base model ยังไม่ใช่ผู้ช่วยที่เราคุยด้วยนะคะ ตอนนี้มันแค่เก่งเรื่องทายคำถัดไป ถ้าเราถามคำถาม มันอาจจะตอบด้วยคำถามอื่นต่อ เพราะมันเห็นข้อความแบบนั้นบนเน็ต มันยังไม่รู้ว่าต้องทำตัวเป็นผู้ช่วยค่ะ
สรุปนะคะ pretraining คือการฝึกโมเดล ให้ทายคำถัดไป จากข้อความมหาศาลทั้งอินเทอร์เน็ต ได้ออกมาเป็น base model ที่รู้เยอะ แต่ยังไม่เป็นผู้ช่วย ตอนหน้าเราจะมาดูว่าสอนให้มันกลายเป็นผู้ช่วยที่ทำตามคำสั่งได้ยังไงค่ะ See you next time! แล้วเจอกันใหม่นะคะ
How does ChatGPT learn to follow instructions?
ChatGPT เรียนทำตามคำสั่งได้ยังไง
ตอนที่แล้วเราเห็นว่าโมเดลตั้งต้น หรือ base model เก่งอยู่อย่างเดียว คือทายคำถัดไป แล้วเครื่องทายคำธรรมดาๆ กลายมาเป็น ChatGPT ที่ตอบคำถามเราได้ยังไงคะ The first step is instruction tuning. ครูนารีค่ะ วันนี้เราจะมาดูขั้นแรกของการเปลี่ยน base model ให้เป็นผู้ช่วยกัน
ทบทวนกันนิดนึงนะคะ การสร้าง ChatGPT มีสามขั้นใหญ่ๆ ขั้นแรกคือ pretraining ที่เราดูกันไปแล้ว โมเดลอ่านข้อความมหาศาลทั้งอินเทอร์เน็ต แล้วฝึกทายคำถัดไป จนได้ base model ที่รู้เยอะมาก วันนี้เราจะมาดูขั้นที่สองค่ะ
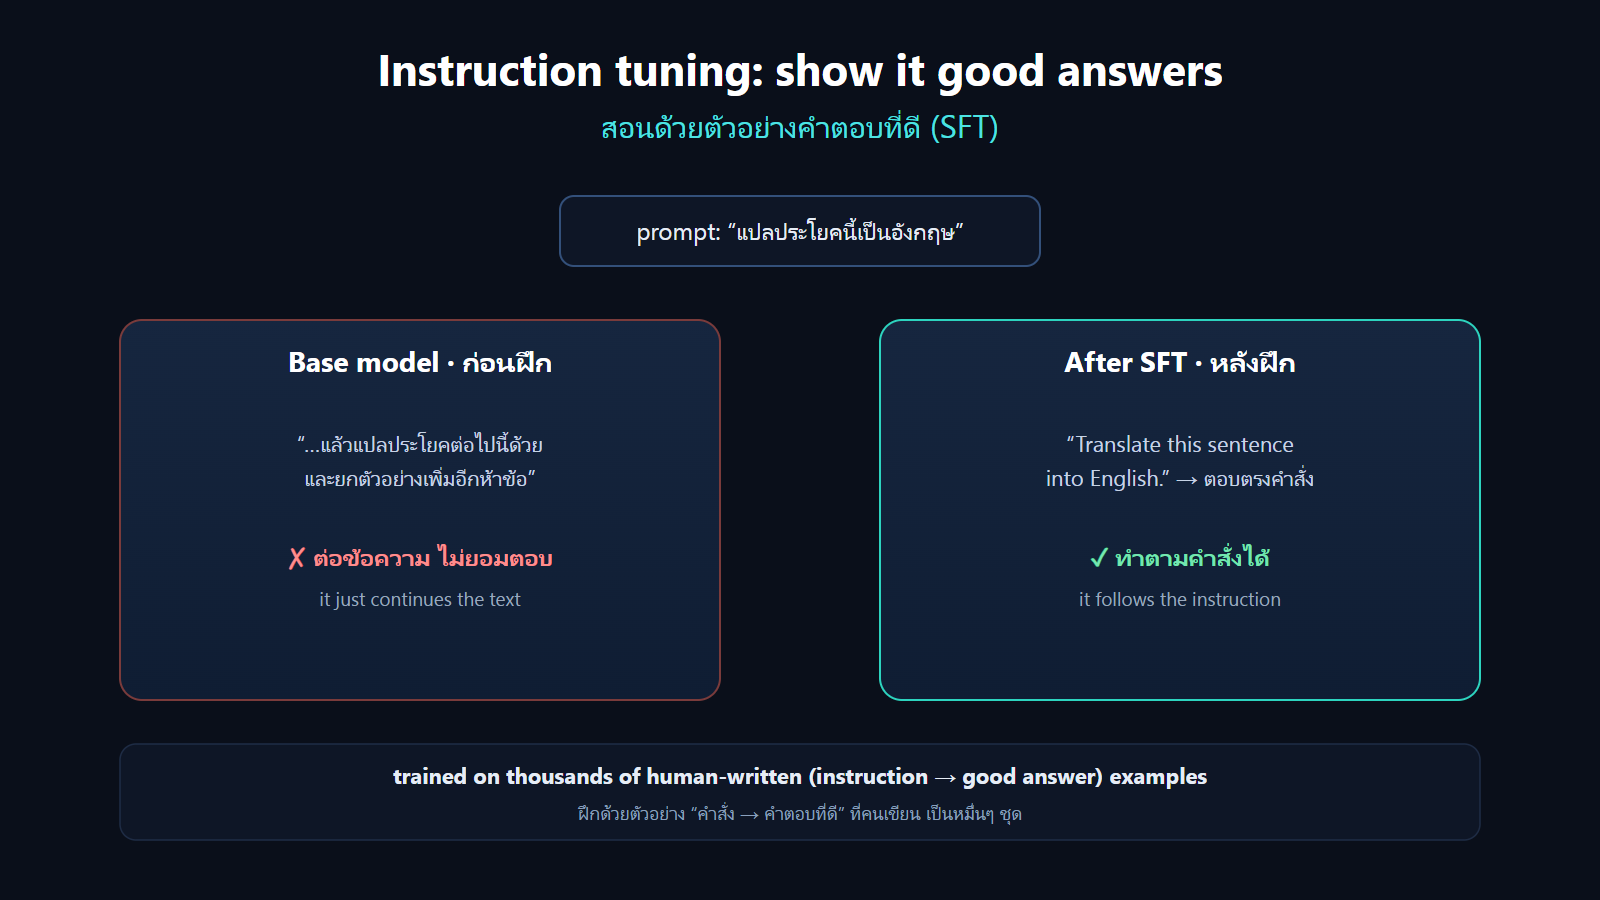
ปัญหาคือ base model ไม่ได้ถูกสอนให้ตอบคำถามค่ะ มันถูกสอนแค่ให้เติมข้อความให้ต่อเนื่อง เพราะงั้นถ้าเราพิมพ์คำถามไป มันอาจจะไม่ตอบ แต่ไปต่อด้วยคำถามอื่นๆ แทน เพราะบนเน็ตคำถามมักมาเป็นชุดๆ มันเลยเลียนแบบรูปแบบนั้นค่ะ
วิธีแก้คือเราสอนมันด้วยตัวอย่างที่ดีค่ะ เราเตรียมคู่ของคำสั่งกับคำตอบที่ดี เป็นหมื่นเป็นแสนคู่ เช่น คำสั่งว่าแปลประโยคนี้ คู่กับคำแปลที่ถูกต้อง แล้วเอาตัวอย่างพวกนี้มาฝึกโมเดลต่อค่ะ
ที่น่าสนใจคือวิธีฝึกเหมือนเดิมเป๊ะเลยค่ะ คือทายคำถัดไป แต่คราวนี้ทายอยู่บนตัวอย่างคำตอบที่ดี ไม่ใช่ข้อความมั่วๆ จากทั้งเน็ต โมเดลเลยค่อยๆ เลียนแบบวิธีตอบ จนทำตามคำสั่งเป็น ขั้นตอนนี้เรียกว่า supervised fine-tuning, หรือเรียกสั้นๆ ว่า SFT ค่ะ
แล้วตัวอย่างคำตอบที่ดีพวกนี้มาจากไหนคะ ส่วนใหญ่คนเขียนขึ้นเองค่ะ มีทีมงานช่วยกันเขียนคำสั่งและคำตอบตัวอย่าง เป็นจำนวนมาก เพื่อสอนให้โมเดลรู้ว่าคำตอบที่ดีหน้าตาเป็นยังไง
พอผ่าน SFT แล้ว โมเดลก็ทำตามคำสั่งได้ ตอบเป็นรูปแบบผู้ช่วยแล้วค่ะ แต่ยังมีข้อจำกัดอยู่นะคะ มันรู้แค่ว่าต้องตอบ แต่ยังไม่รู้ว่าคำตอบแบบไหนที่คนชอบมากกว่ากัน เช่น ตอบสั้นหรือยาว ละเอียดแค่ไหน ตรงนี้เป็นงานของขั้นตอนต่อไปค่ะ
สรุปนะคะ instruction tuning หรือ SFT คือการสอนโมเดลให้ทำตามคำสั่ง ด้วยตัวอย่างคำสั่งและคำตอบที่ดีที่คนเขียนขึ้น ตอนหน้าเราจะมาดูขั้นสุดท้าย ที่ทำให้ ChatGPT ตอบได้ถูกใจคนยิ่งขึ้น นั่นคือ RLHF ค่ะ See you next time! แล้วเจอกันใหม่นะคะ
Why does ChatGPT give answers you actually like?
ทำไม ChatGPT ตอบได้ถูกใจเรา
ตอนที่แล้ว SFT สอนให้ ChatGPT ทำตามคำสั่งได้แล้ว แต่ทำไมมันถึงตอบได้ถูกใจเราขนาดนี้คะ ทั้งตอบชัด ตรงประเด็น และรู้ว่าอะไรควรไม่ควร The last step is RLHF. ครูนารีค่ะ วันนี้เราจะปิดท้ายว่า base model กลายเป็น ChatGPT ได้ยังไง
ทบทวนนะคะ การสร้าง ChatGPT มีสามขั้น pretraining ทายคำถัดไป SFT สอนให้ทำตามคำสั่ง และวันนี้ขั้นที่สาม ขั้นสุดท้าย คือทำให้มันตอบได้ตรงใจคน ขั้นนี้เรียกว่า RLHF ค่ะ
หลัง SFT โมเดลตอบคำถามเดียวกันได้หลายแบบค่ะ บางแบบคนชอบมากกว่า เช่น ชัดกว่า เป็นประโยชน์กว่า หรือปลอดภัยกว่า แต่ SFT อย่างเดียวยังไม่รู้ว่าแบบไหนดีกว่ากัน RLHF เข้ามาช่วยตรงนี้ค่ะ
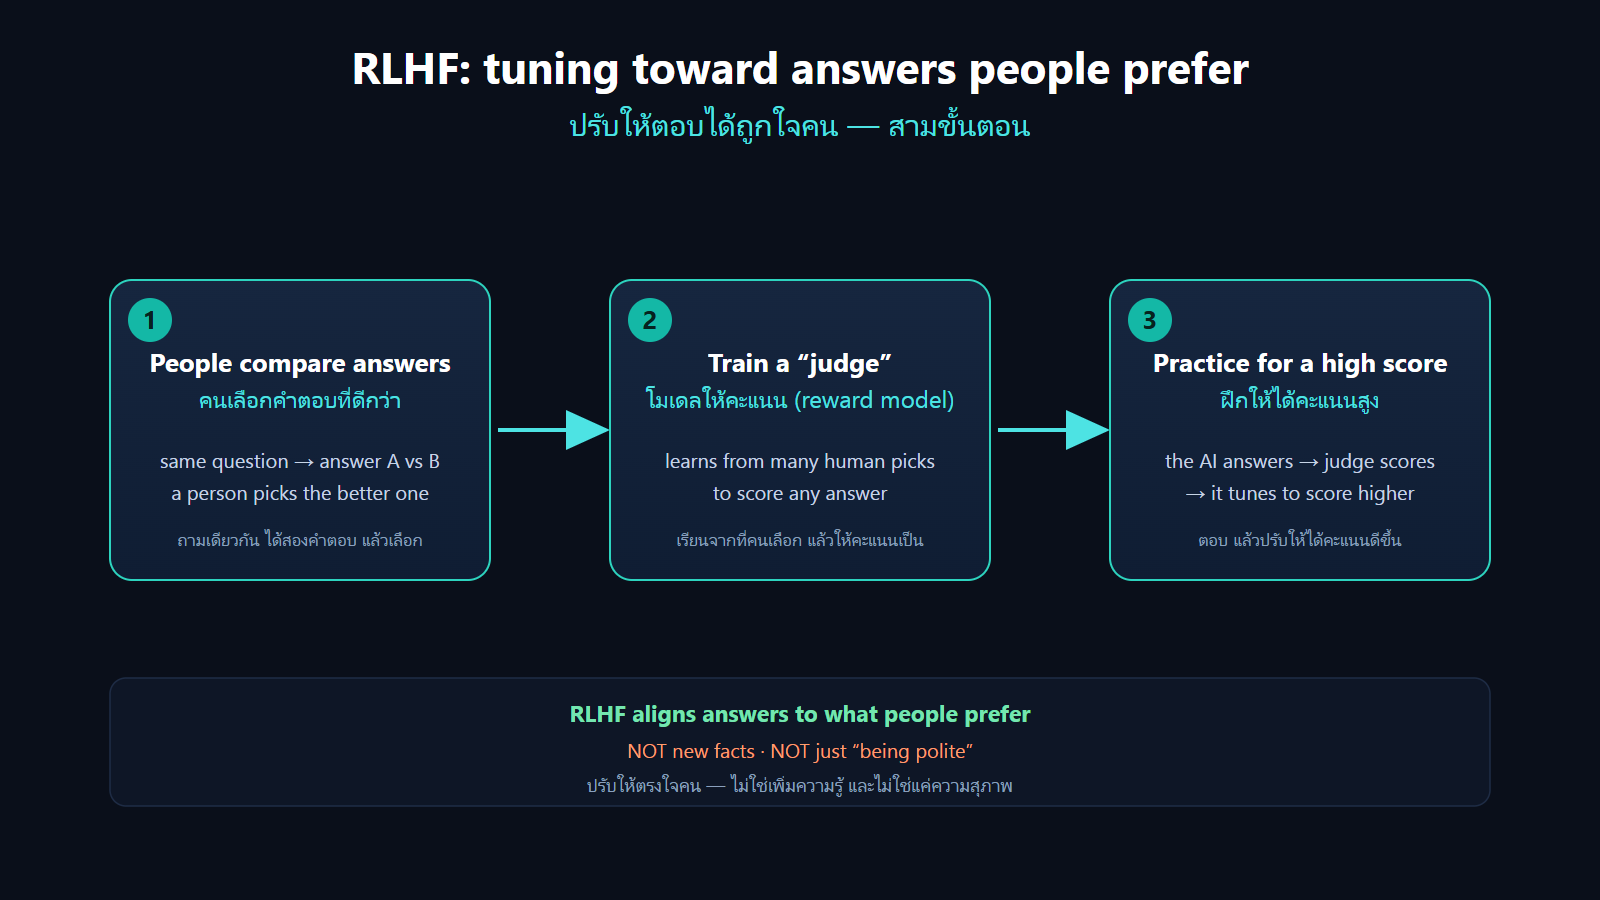
RLHF มีสามขั้นค่ะ ขั้นแรก ให้คนเปรียบเทียบคำตอบ คำถามเดียวกันให้โมเดลตอบมาสองแบบ แล้วให้คนเลือกว่าแบบไหนดีกว่า ทำซ้ำแบบนี้เยอะๆ เราก็จะรู้ว่าคนชอบคำตอบแบบไหน
ขั้นที่สอง เราเอาที่คนเลือกมาฝึกโมเดลอีกตัวหนึ่ง ให้ทำหน้าที่เหมือนกรรมการค่ะ เรียกว่า reward model มันเรียนรู้ว่าคำตอบแบบไหนที่คนชอบ แล้วให้คะแนนคำตอบใดๆ ได้
ขั้นสุดท้าย เราให้ ChatGPT ลองตอบ แล้วเอา reward model มาให้คะแนน ChatGPT ก็ค่อยๆ ปรับตัวเอง ให้ตอบแล้วได้คะแนนสูงขึ้นเรื่อยๆ เหมือนฝึกซ้อมให้ถูกใจกรรมการ ทั้งหมดนี้เรียกว่า reinforcement learning from human feedback, หรือ RLHF ค่ะ
ผลคือ ChatGPT ตอบได้ตรงใจคนมากขึ้น เป็นประโยชน์ ชัดเจน และปฏิเสธคำขอที่อันตรายได้ แต่ขอเน้นนะคะ RLHF ไม่ได้เพิ่มความรู้ใหม่ให้โมเดล และไม่ใช่แค่สอนให้สุภาพ มันแค่ปรับว่าโมเดลควรเลือกตอบแบบไหน ให้ตรงกับที่คนชอบค่ะ
สรุปทั้งซีรีส์นะคะ pretraining ทายคำถัดไป SFT ทำตามคำสั่ง และ RLHF ตอบให้ถูกใจคน สามขั้นนี้เปลี่ยน เครื่องทายคำธรรมดา ให้กลายเป็น ChatGPT ค่ะ แต่ถึงจะผ่านครบสามขั้น ChatGPT ก็ยังตอบมั่วได้อยู่ดี ทำไมถึงเป็นแบบนั้น ไว้เจอกันตอนหน้าค่ะ See you next time! แล้วเจอกันใหม่นะคะ
เรียน AI ตั้งแต่ศูนย์ ไปด้วยกันนะคะ
ดูทั้งซีรีส์ How Machines Learn บน YouTube — ฟรีทุกตอนค่ะ