DGX Spark เร็วพอจริงไหม? เราวัดเองห้าโมเดลบนเครื่องจริง แล้วเจอกติกาง่ายๆ ว่า ความเร็วตอนตอบ เท่ากับ ความเร็วขนข้อมูล หารด้วยขนาดโมเดลค่ะ
We measured five models on our own GB10. Why it reads fast but writes slowly.
📑 ช่วงเวลา / Chapters
Is the DGX Spark fast enough? We measured it
DGX Spark เร็วพอจริงไหม? เราวัดเอง
เครื่องที่อยู่ตรงหน้าเราตอนนี้ แรงระดับหนึ่งเพตะฟลอป คือคำนวณได้เป็นพันล้านล้านครั้งต่อวินาทีค่ะ แต่พอให้มันพิมพ์คำตอบออกมา มันกลับช้ากว่าเราพิมพ์เองซะอีก แปลกไหมคะ เครื่องที่เร็วขนาดนี้ ทำไมถึงตอบช้า วันนี้เราจะไม่เดาค่ะ เราจะวัดเองกับเครื่องที่บ้าน ห้าโมเดล แล้วเราเจอกติกาง่ายๆ ข้อเดียว ที่อธิบายเรื่องนี้ได้ทั้งหมดเลยค่ะ
คำถามนี้สำคัญกว่าที่คิดนะคะ เพราะเวลาเราจะซื้อเครื่องมารัน AI เองที่บ้านหรือที่โรงเรียน เรามักดูแค่ตัวเลขความแรง แต่ตัวเลขความแรงที่โฆษณากัน มันไม่ได้บอกว่าเครื่องจะตอบเราเร็วแค่ไหน มันคนละเรื่องกันเลยค่ะ วันนี้เราจะไล่ให้ดูทีละขั้นนะคะ ว่าทำไมมันถึงเป็นแบบนั้น แล้วเราจะได้สูตรง่ายๆ ติดมือกลับไป ที่เอาไปคำนวณเองได้เลยว่า โมเดลที่เราอยากใช้ จะวิ่งบนเครื่องของเราได้เร็วแค่ไหน ก่อนจะจ่ายเงินซื้อค่ะ
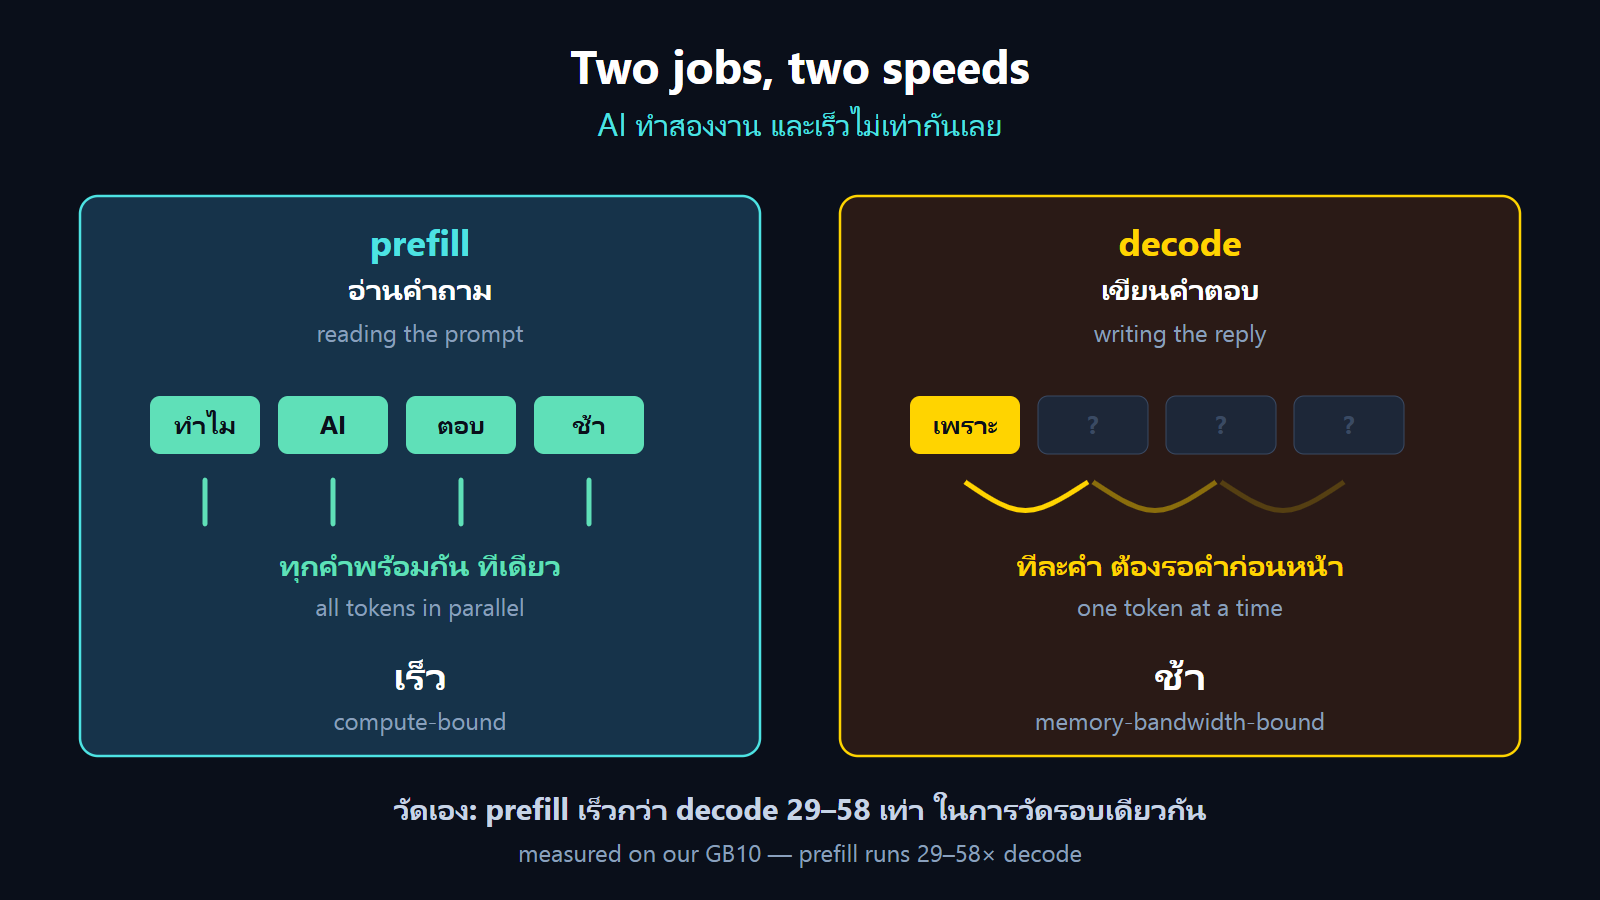
เวลา AI ทำงาน มันทำสองงานที่ต่างกันมากค่ะ งานแรกคืออ่านคำถามของเรา ภาษาเทคนิคเรียกว่า prefill งานที่สองคือเขียนคำตอบออกมาทีละคำ เรียกว่า decode สองงานนี้ใช้ทรัพยากรคนละแบบ และเร็วไม่เท่ากันเลยค่ะ ตอนอ่าน มันอ่านทุกคำพร้อมกันได้ทีเดียว แต่ตอนเขียน มันต้องเขียนทีละคำ แล้วเอาคำที่เพิ่งเขียน กลับไปคิดต่อค่ะ
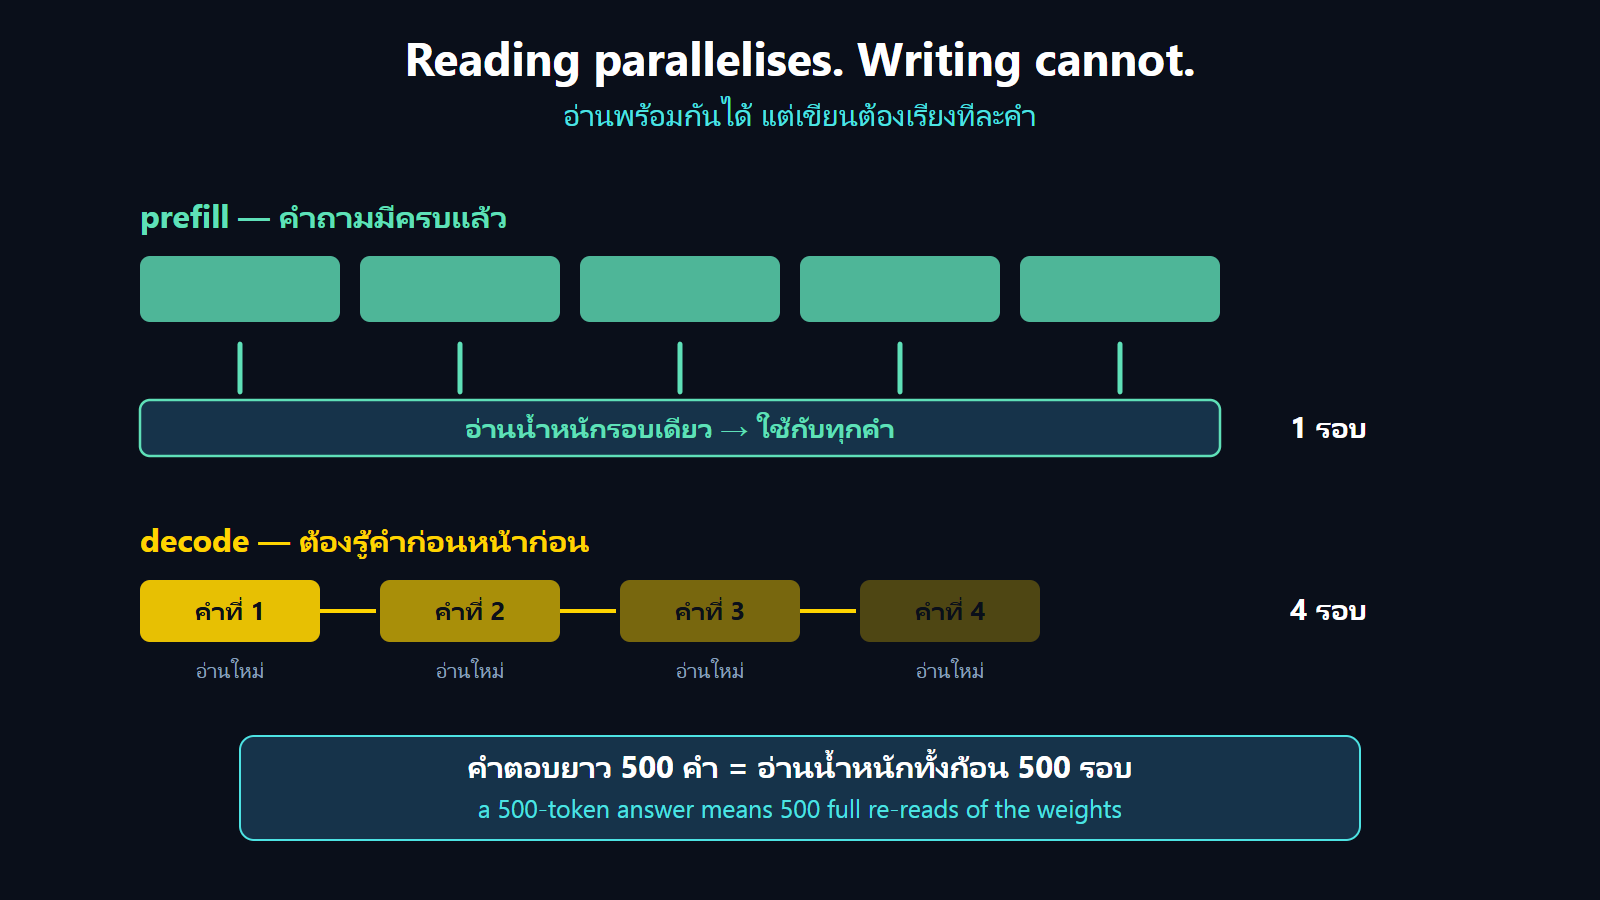
ลองนึกภาพบรรณารักษ์คนหนึ่งนะคะ โต๊ะเต็มไปด้วยหนังสือ กติกาคือ ก่อนจะเขียนได้หนึ่งคำ เขาต้องเปิดอ่านหนังสือทุกเล่มบนโต๊ะก่อน หนึ่งรอบ เขียนคำเดียว อ่านใหม่ทั้งโต๊ะ เขียนอีกคำ อ่านใหม่ทั้งโต๊ะอีกรอบ ยิ่งหนังสือเยอะ ก็ยิ่งเขียนช้าค่ะ AI ก็ทำแบบนี้เป๊ะๆ เลย หนังสือบนโต๊ะก็คือน้ำหนักของโมเดล ที่มันต้องอ่านใหม่ทุกครั้งที่จะสร้างคำถัดไปค่ะ
แล้วทำไมตอนอ่าน ถึงเร็วกว่ากันขนาดนั้นคะ เพราะตอนอ่านคำถาม ทุกคำมีอยู่ครบแล้วตั้งแต่แรก เครื่องเลยยัดทุกคำเข้าไปคำนวณพร้อมกันได้เลย อ่านน้ำหนักโมเดลรอบเดียว แล้วใช้กับทุกคำในคำถามได้หมดค่ะ แต่ตอนเขียนคำตอบ มันทำแบบนั้นไม่ได้ เพราะคำที่สอง ต้องรู้ก่อนว่าคำแรกคืออะไร คำที่สามต้องรอคำที่สอง มันเลยขนานกันไม่ได้เลยค่ะ ต้องเรียงกันไปทีละคำ แล้วแต่ละคำก็ต้องอ่านน้ำหนักใหม่ทั้งก้อนอีกรอบ นี่คือเหตุผลเดียว ที่ทำให้สองงานนี้เร็วต่างกันหลายสิบเท่าค่ะ
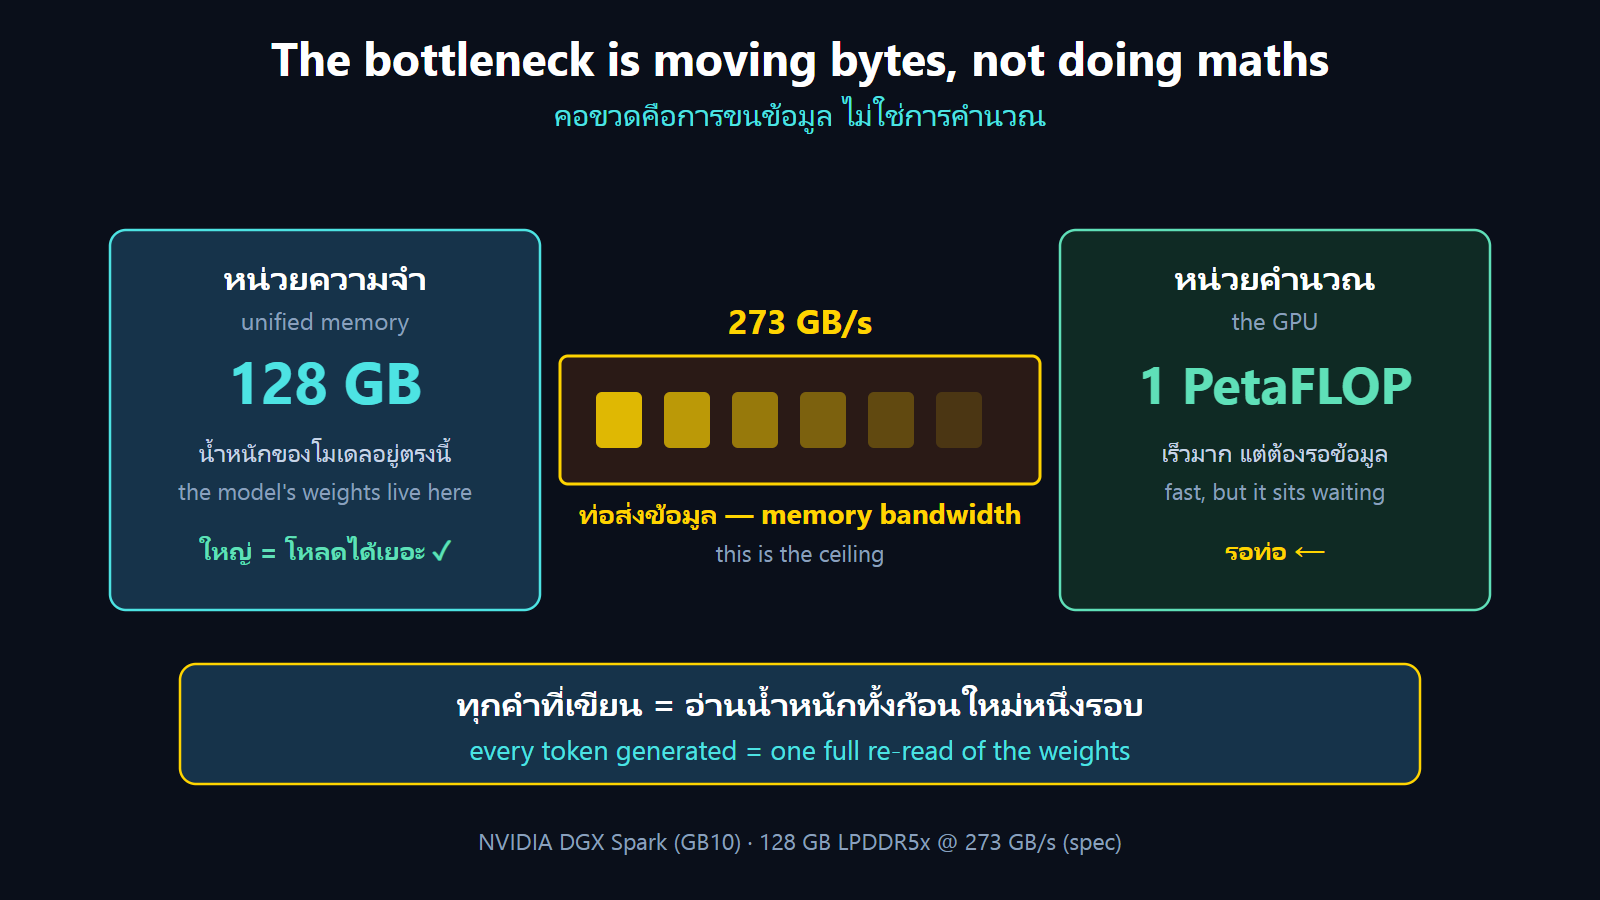
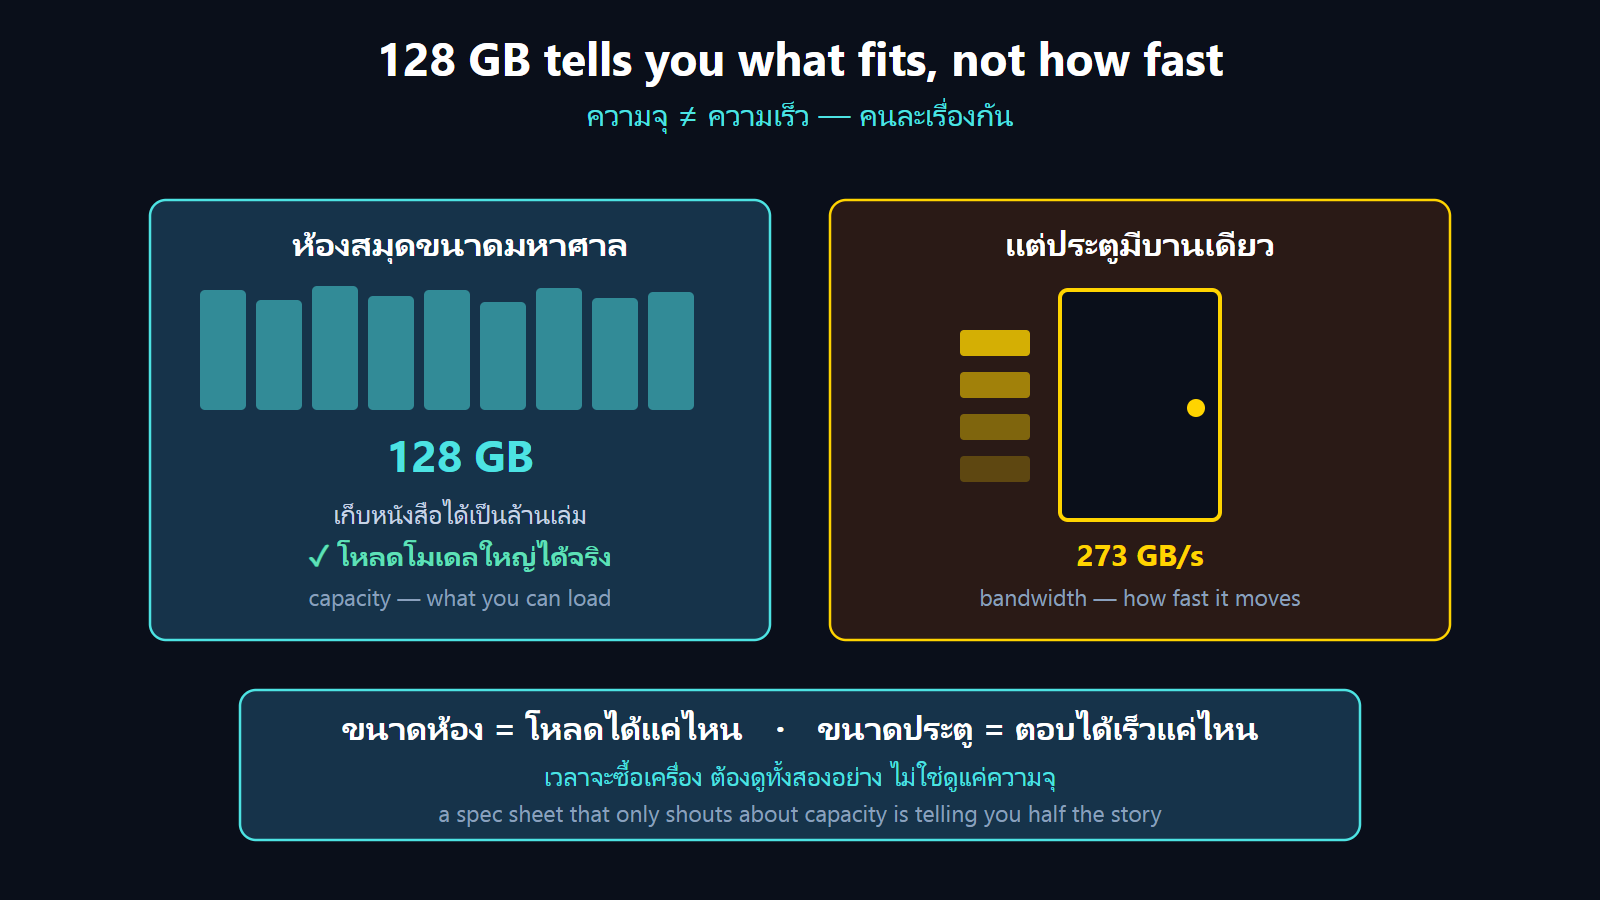
ทีนี้ก็ตอบคำถามตอนต้นได้แล้วค่ะ ที่เครื่องแรงแต่ตอบช้า เพราะคอขวดมันไม่ได้อยู่ที่ความเร็วในการคำนวณ แต่อยู่ที่ความเร็วในการขนข้อมูลจากหน่วยความจำ เรียกว่า memory bandwidth เครื่อง DGX Spark ที่เราใช้ มีหน่วยความจำ หนึ่งร้อยยี่สิบแปดกิกะไบต์ ขนข้อมูลได้สองร้อยเจ็ดสิบสามกิกะไบต์ต่อวินาทีค่ะ ตัวเลขนี้แหละ ที่เป็นเพดานของความเร็วตอนเขียนคำตอบ แล้วถ้าใครลองเปิดดูการ์ดจอ บนเครื่องแบบนี้ แล้วเห็นช่องหน่วยความจำขึ้นว่า ไม่มีข้อมูล ไม่ต้องตกใจนะคะ เครื่องไม่ได้เสียค่ะ เพราะเครื่องแบบนี้ใช้หน่วยความจำก้อนเดียวร่วมกันทั้งซีพียูและจีพียู มันเลยไม่มีหน่วยความจำแยกของการ์ดจอให้รายงานค่ะ สิ่งที่บอกความสามารถของเครื่องจริงๆ คือความเร็วในการขนข้อมูล ไม่ใช่ตัวเลขตรงนั้น
ตรงนี้เป็นจุดที่คนเข้าใจผิดกันเยอะที่สุดค่ะ พอเห็นว่าเครื่องมีหน่วยความจำตั้งร้อยยี่สิบแปดกิกะไบต์ ก็คิดว่ารันโมเดลใหญ่ๆ ได้สบายแน่นอน ซึ่งจริงแค่ครึ่งเดียวค่ะ หน่วยความจำใหญ่ บอกว่าเรา โหลด โมเดลใหญ่แค่ไหนได้ แต่ไม่ได้บอกว่ามันจะตอบเร็วแค่ไหนเลย สองเรื่องนี้แยกกันคนละเรื่องค่ะ เหมือนห้องสมุดที่ใหญ่มาก เก็บหนังสือได้เป็นล้านเล่ม แต่ประตูทางเข้ามีบานเดียว ยิ่งต้องขนหนังสือเยอะ ก็ยิ่งช้า ขนาดห้องคือความจุ ประตูคือความเร็วขนข้อมูล เวลาจะซื้อเครื่อง ต้องดูทั้งสองอย่างนะคะ ไม่ใช่ดูแค่ตัวเลขความจุค่ะ
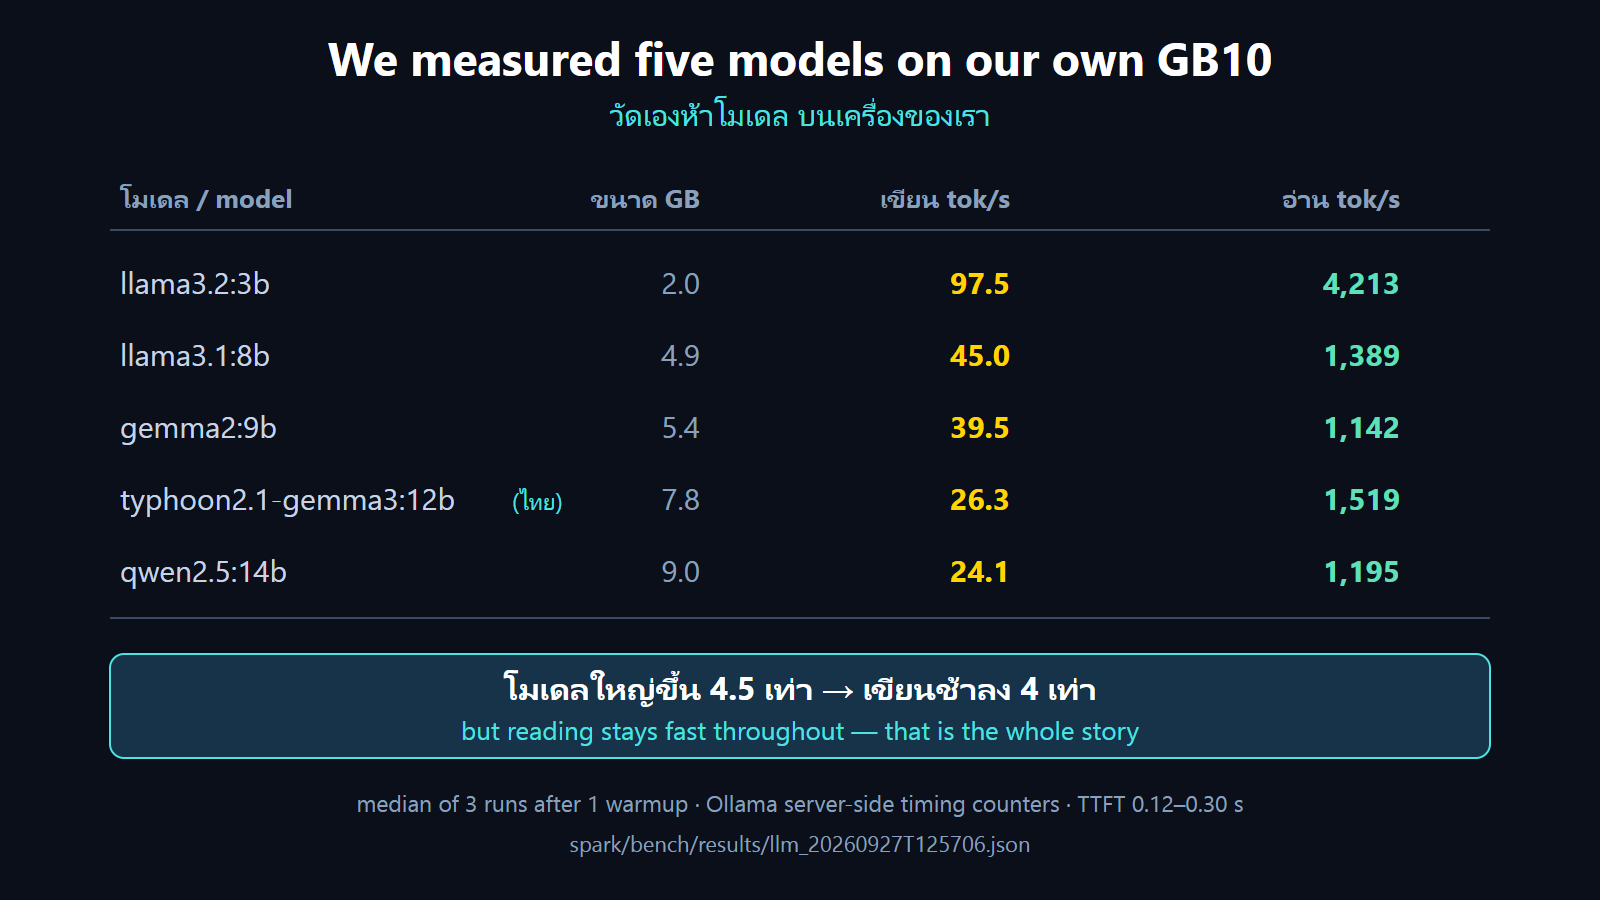
เราวัดเองกับเครื่องที่บ้านค่ะ ห้าโมเดล ตั้งแต่ตัวเล็กสามพันล้านพารามิเตอร์ ไปจนถึงสิบสี่พันล้าน ตัวเล็กสุดเขียนได้เก้าสิบเจ็ดคำต่อวินาที ตัวใหญ่สุดเหลือยี่สิบสี่คำต่อวินาทีค่ะ ช้าลงสี่เท่า แต่ตอนอ่านคำถามนี่สิคะ เร็วกว่าตอนเขียนสามสิบถึงห้าสิบแปดเท่า ในการวัดรอบเดียวกันเลย นี่คือที่มาของคำว่า อ่านเร็ว แต่ตอบช้า ค่ะ
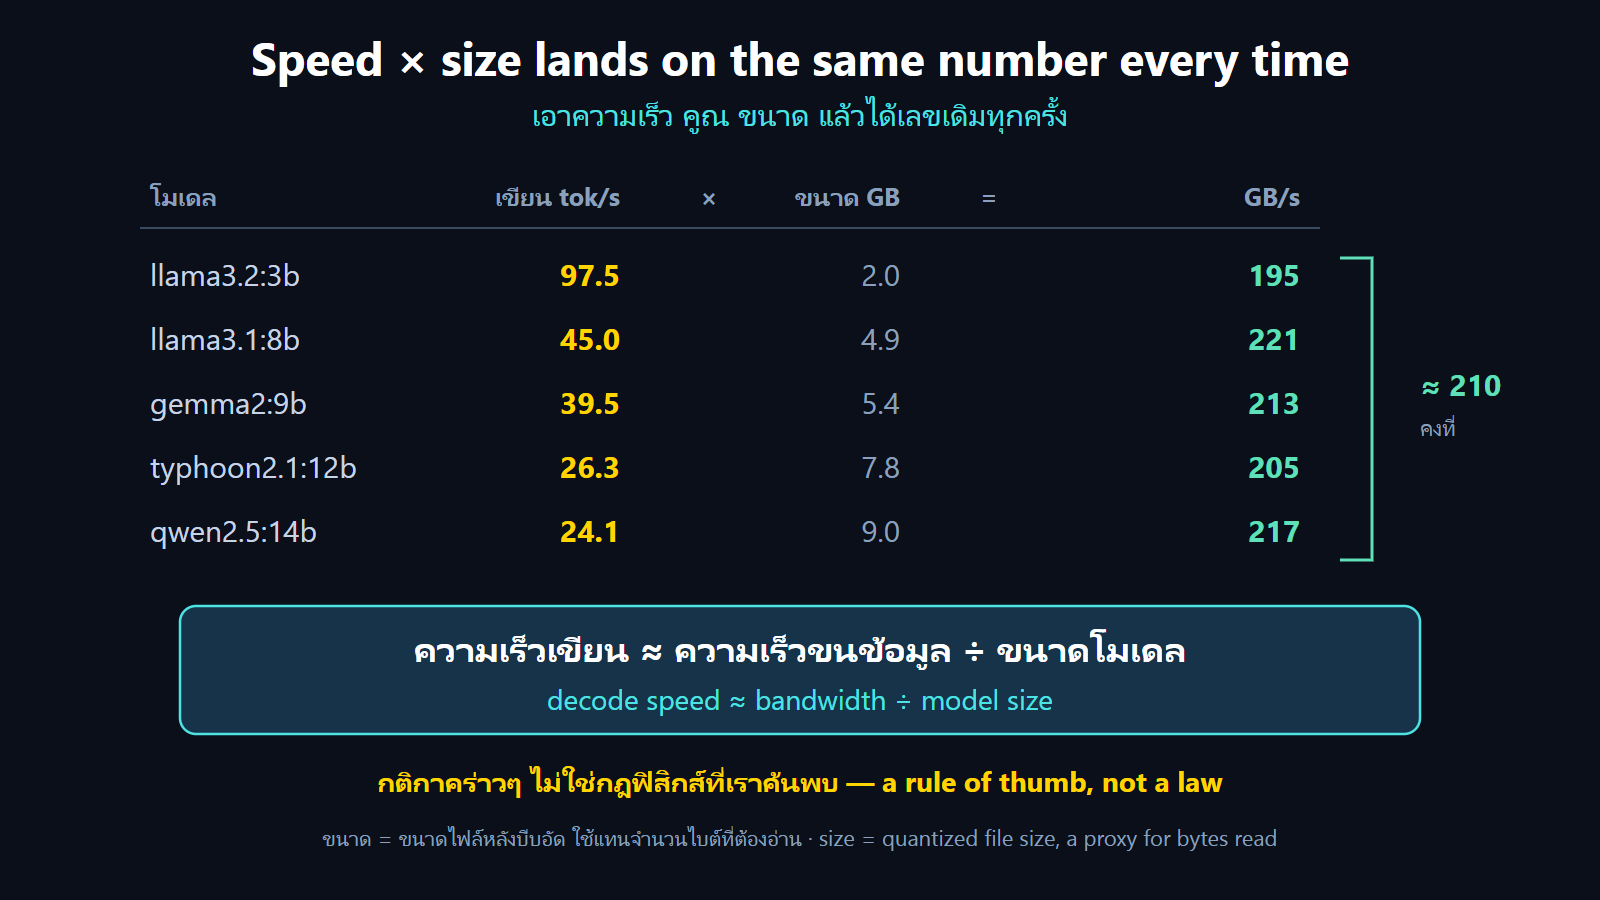
ทีนี้ลองทำอะไรสนุกๆ ค่ะ เอาความเร็วตอนเขียน คูณกับขนาดไฟล์ของโมเดล แล้วดูว่าได้เท่าไหร่ ปรากฏว่าทั้งห้าโมเดล ได้ตัวเลขใกล้กันหมดเลยค่ะ ประมาณสองร้อยสิบ ทั้งที่ขนาดต่างกันหลายเท่า แปลว่าความเร็วตอนเขียน เท่ากับ ความเร็วขนข้อมูล หารด้วยขนาดโมเดล เป็นกติกาคร่าวๆ ที่ใช้ทำนายได้เลยค่ะ ย้ำนะคะว่าคร่าวๆ นี่ไม่ใช่กฎฟิสิกส์ที่เราค้นพบ มันคือรูปแบบที่เราวัดได้ และมันตรงกับที่ฟิสิกส์บอกไว้อยู่แล้วค่ะ
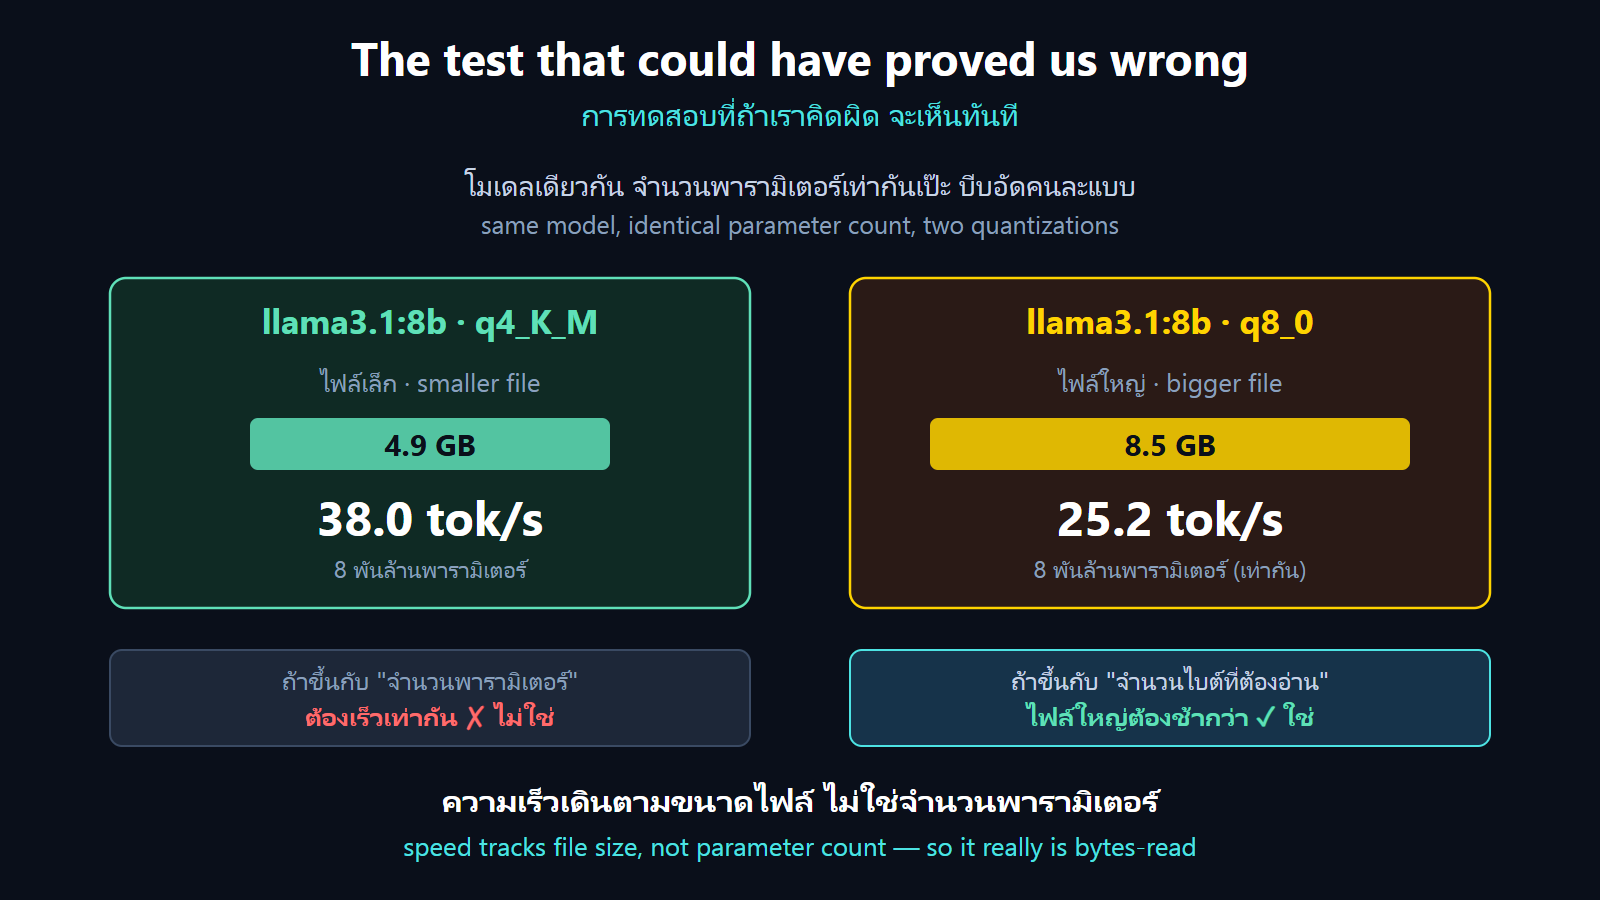
แล้วเราจะรู้ได้ยังไงว่ากติกานี้จริง ไม่ใช่แค่บังเอิญคะ ต้องหาวิธีพิสูจน์ว่ามันผิดได้ค่ะ เราเอาโมเดลตัวเดียวกันเป๊ะๆ จำนวนพารามิเตอร์เท่ากัน แต่บีบอัดสองแบบ ให้ไฟล์ใหญ่ต่างกันเกือบสองเท่า ถ้าความเร็วขึ้นกับจำนวนพารามิเตอร์ มันต้องเท่ากัน แต่ถ้าขึ้นกับขนาดไฟล์ ตัวไฟล์ใหญ่ต้องช้ากว่า ผลคือตัวไฟล์ใหญ่ช้ากว่าจริงค่ะ ความเร็วเดินตามขนาดไฟล์ ไม่ใช่จำนวนพารามิเตอร์ แปลว่าสิ่งที่เป็นคอขวด คือจำนวนไบต์ที่ต้องอ่าน ตรงตามที่เราคิดไว้เลยค่ะ
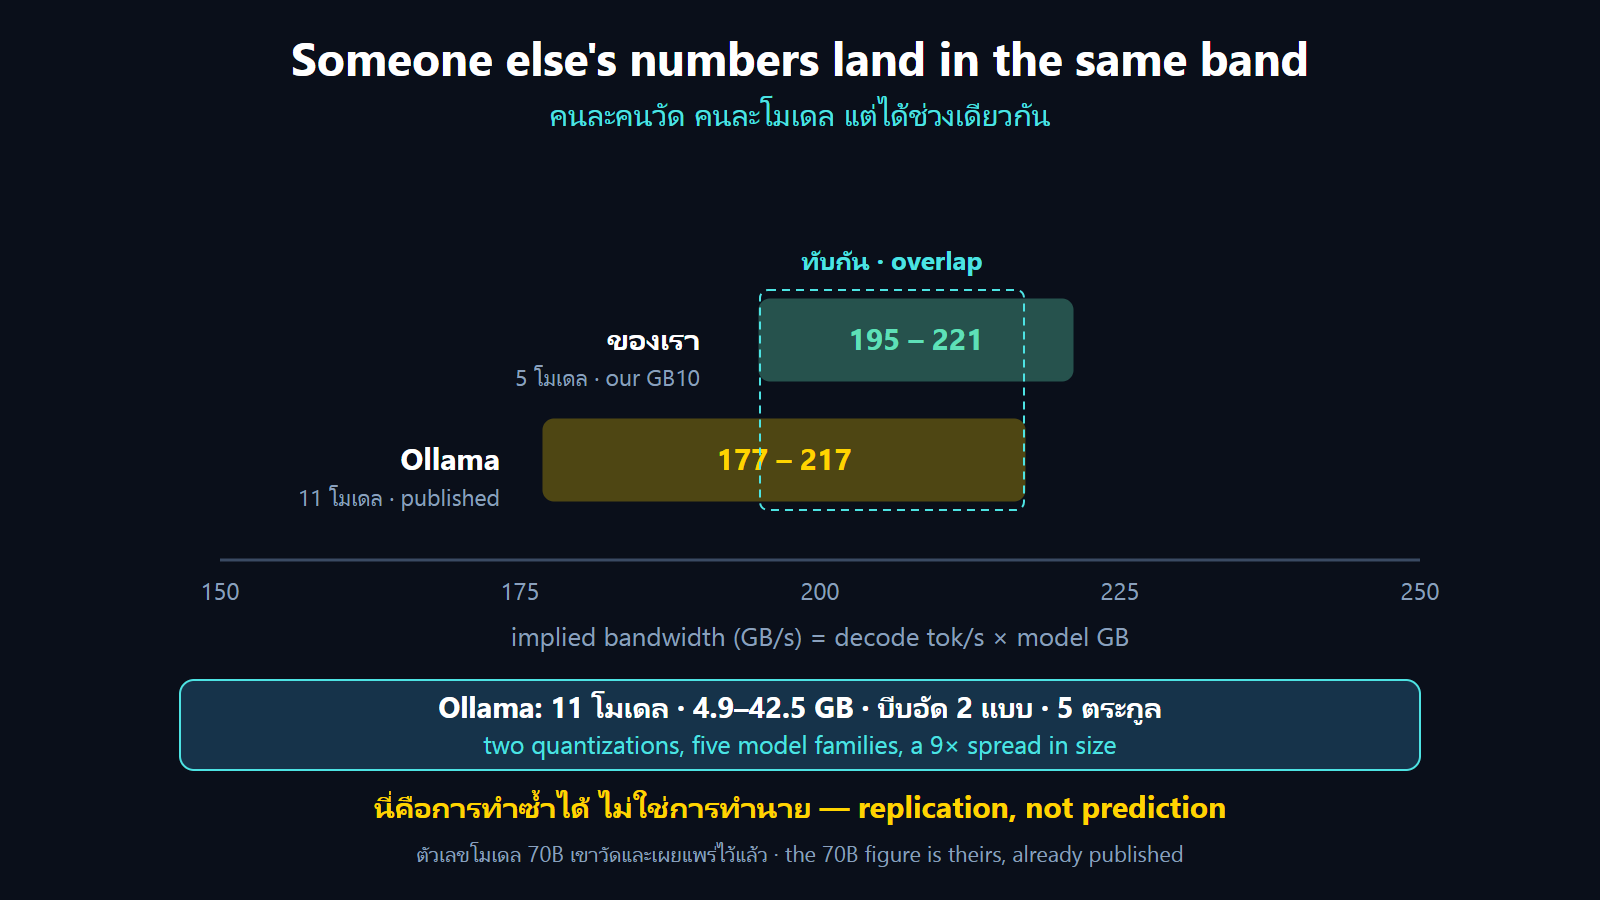
ทีนี้มาเทียบกับคนอื่นบ้างค่ะ Ollama เขาเผยแพร่ผลวัดเครื่องรุ่นเดียวกันไว้สิบเอ็ดโมเดล คนละตัวกับของเราเลย ขนาดตั้งแต่ห้ากิกะไบต์ ไปถึงสี่สิบสองกิกะไบต์ บีบอัดสองแบบ ห้าตระกูล เอากติกาเดิมไปจับ ได้ประมาณร้อยเก้าสิบสี่ ซึ่งทับกับช่วงที่เราวัดได้เองพอดีค่ะ คนละเครื่อง คนละโมเดล คนละคนวัด แต่ได้ช่วงเดียวกัน นี่คือการทำซ้ำได้ ไม่ใช่การทำนายนะคะ ตัวเลขของโมเดลใหญ่ เขาวัดไว้แล้ว เราแค่ยืนยันว่ากติกาเดียวกันใช้ได้ทั้งสองชุดค่ะ
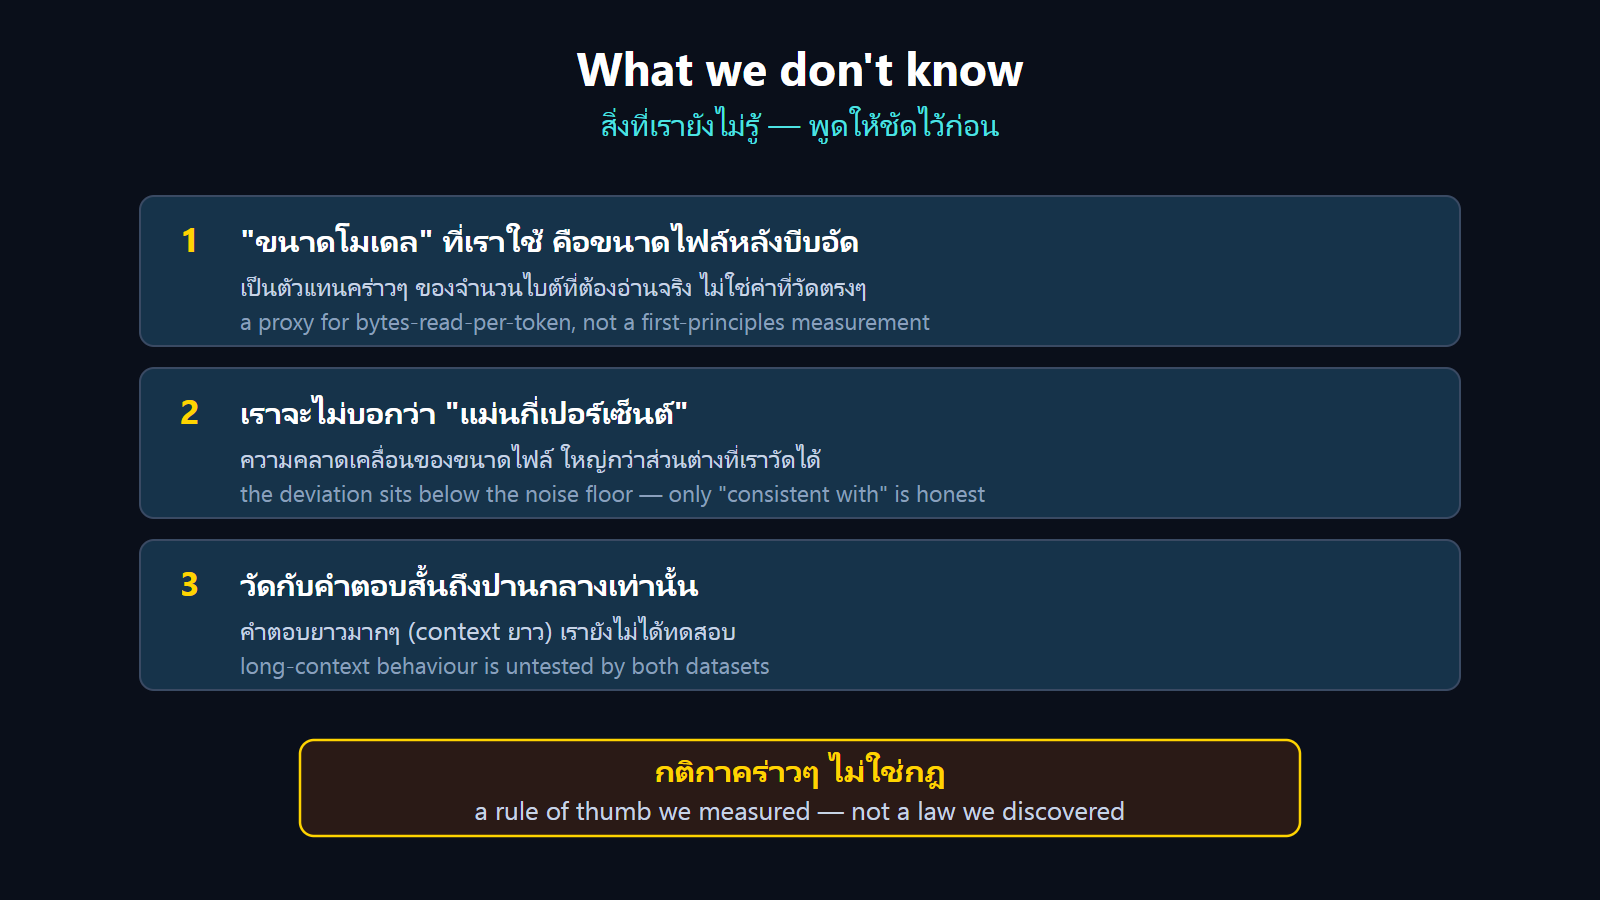
ตรงนี้ต้องพูดให้ชัดค่ะ ว่าอะไรที่เรายังไม่รู้ ขนาดโมเดลที่เราเอาไปคูณ คือขนาดไฟล์หลังบีบอัด ซึ่งเป็นตัวแทนคร่าวๆ ของจำนวนไบต์ที่ต้องอ่านจริง ไม่ใช่ค่าที่วัดตรงๆ ค่ะ เพราะงั้นเวลาตัวเลขสองชุดออกมาใกล้กัน เราจะบอกได้แค่ว่า ตรงกันในระดับที่ความคลาดเคลื่อนของขนาดไฟล์ยอมให้ เราจะไม่บอกว่าแม่นกี่เปอร์เซ็นต์ เพราะความคลาดเคลื่อนมันใหญ่กว่าส่วนต่างอยู่แล้วค่ะ แล้วทั้งหมดนี้วัดกับคำตอบสั้นถึงปานกลางนะคะ คำตอบยาวมากๆ เรายังไม่ได้ทดสอบค่ะ
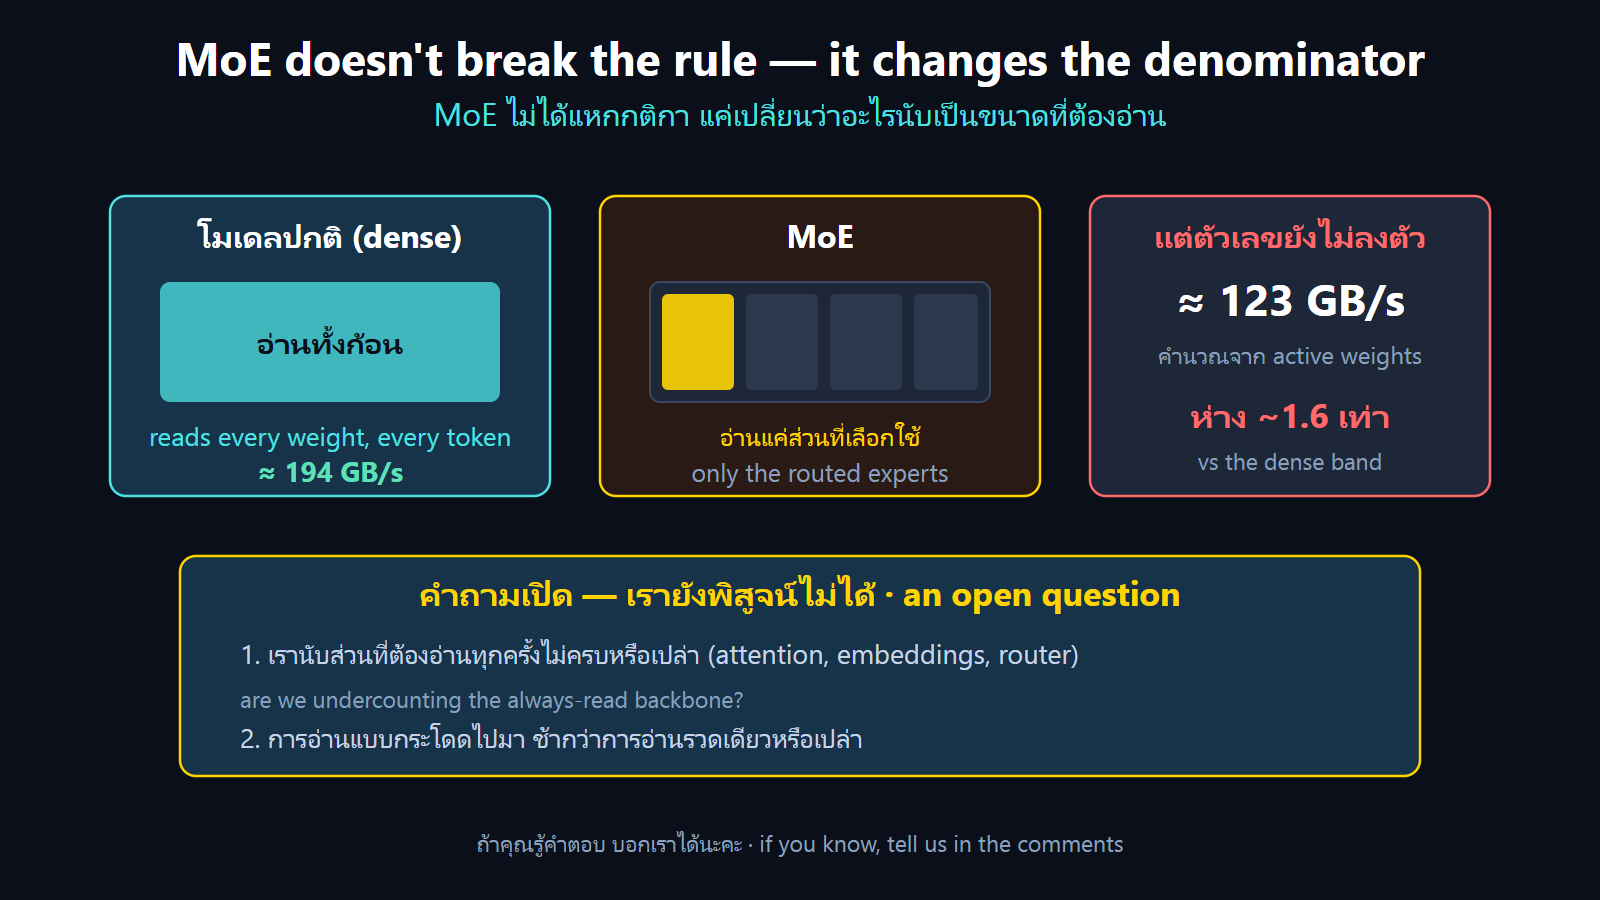
แล้วโมเดลแบบ MoE ล่ะคะ โมเดลแบบนี้ตัวใหญ่มาก แต่เวลาสร้างแต่ละคำ มันไม่ได้อ่านทั้งตัว มันเลือกอ่านแค่บางส่วน โมเดลร้อยยี่สิบพันล้าน เลยเร็วกว่าที่ควรจะเป็นค่ะ แต่เดี๋ยวก่อนนะคะ อันนี้ไม่ได้แปลว่ามันแหกกติกา มันแค่เปลี่ยนว่า อะไรนับเป็นขนาดที่ต้องอ่าน และตรงนี้เรายังคำนวณไม่ลงตัวค่ะ ตัวเลขเรายังห่างอยู่ประมาณหนึ่งจุดหกเท่า เราเดาว่าเรานับส่วนที่ต้องอ่านทุกครั้งไม่ครบ หรือการอ่านแบบกระโดดไปมา มันช้ากว่าการอ่านรวดเดียว แต่เรายังไม่ได้พิสูจน์ค่ะ ใครรู้คำตอบบอกเราได้นะคะ
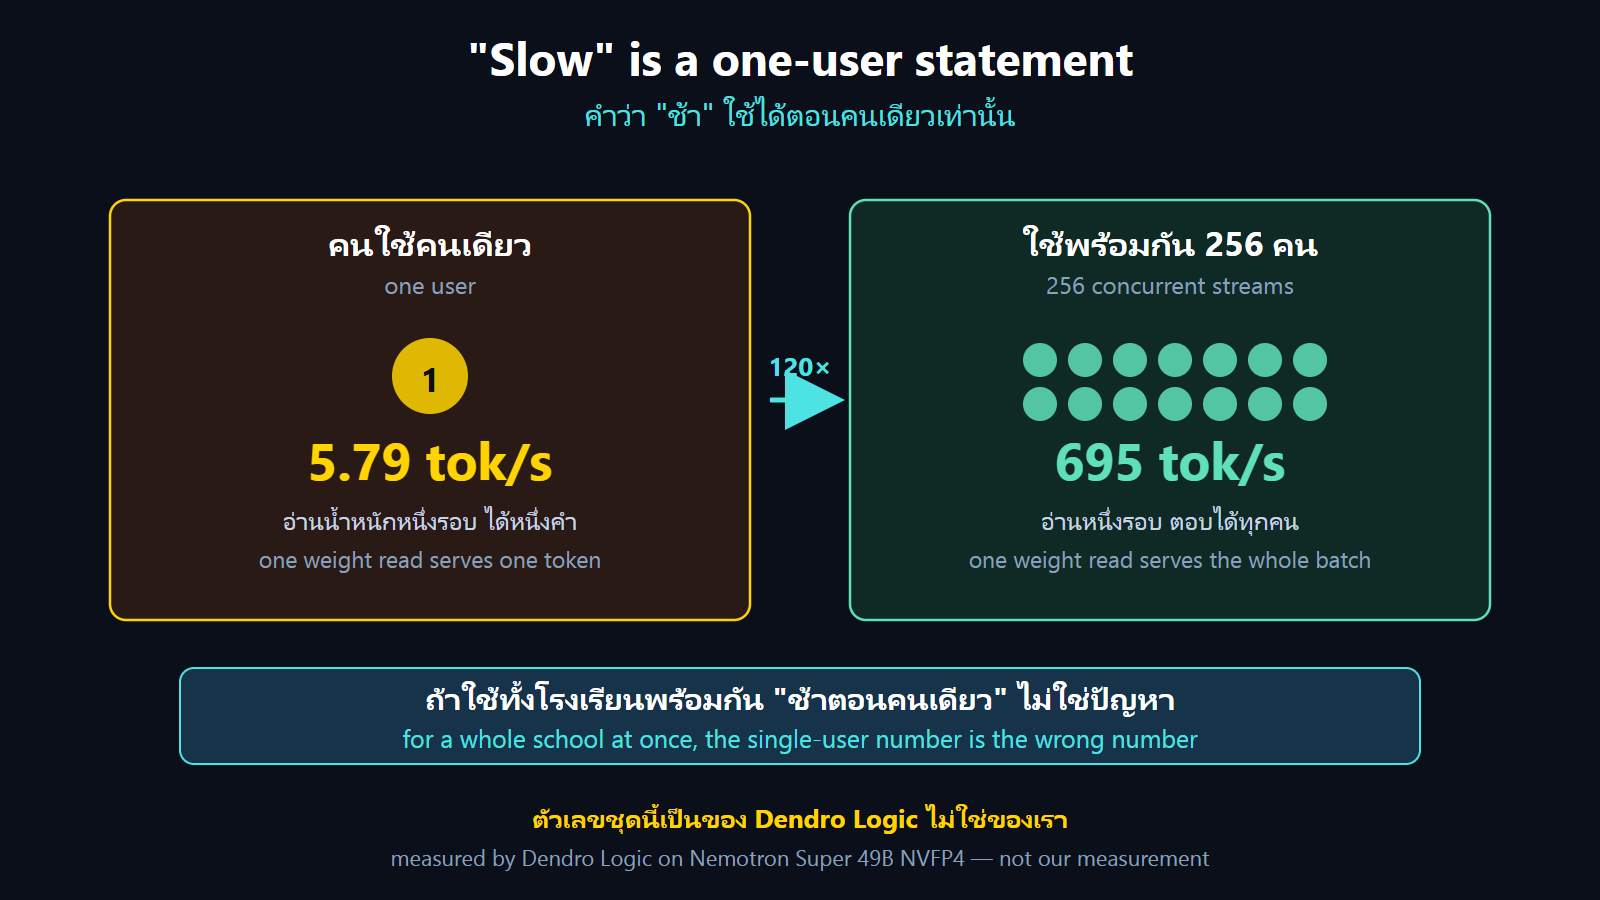
อีกเรื่องที่ต้องพูดถึงค่ะ ที่บอกว่าช้า มันช้าตอนใช้คนเดียว แต่ถ้ามีคนใช้พร้อมกันหลายคน เรื่องเปลี่ยนเลยค่ะ เพราะการอ่านน้ำหนักหนึ่งรอบ ใช้ตอบได้ทุกคนพร้อมกัน มีทีมชื่อ Dendro Logic เขาวัดไว้ว่า พอมีคนใช้พร้อมกันสองร้อยห้าสิบหกคน ยอดรวมขึ้นไปถึงหกร้อยเก้าสิบห้าคำต่อวินาทีค่ะ นี่เป็นตัวเลขของเขานะคะ ไม่ใช่ของเรา เพราะงั้นถ้าจะเอาไปใช้ทั้งโรงเรียน คำว่าช้าตอนคนเดียว มันไม่ได้แปลว่าช้าสำหรับงานแบบนั้นค่ะ
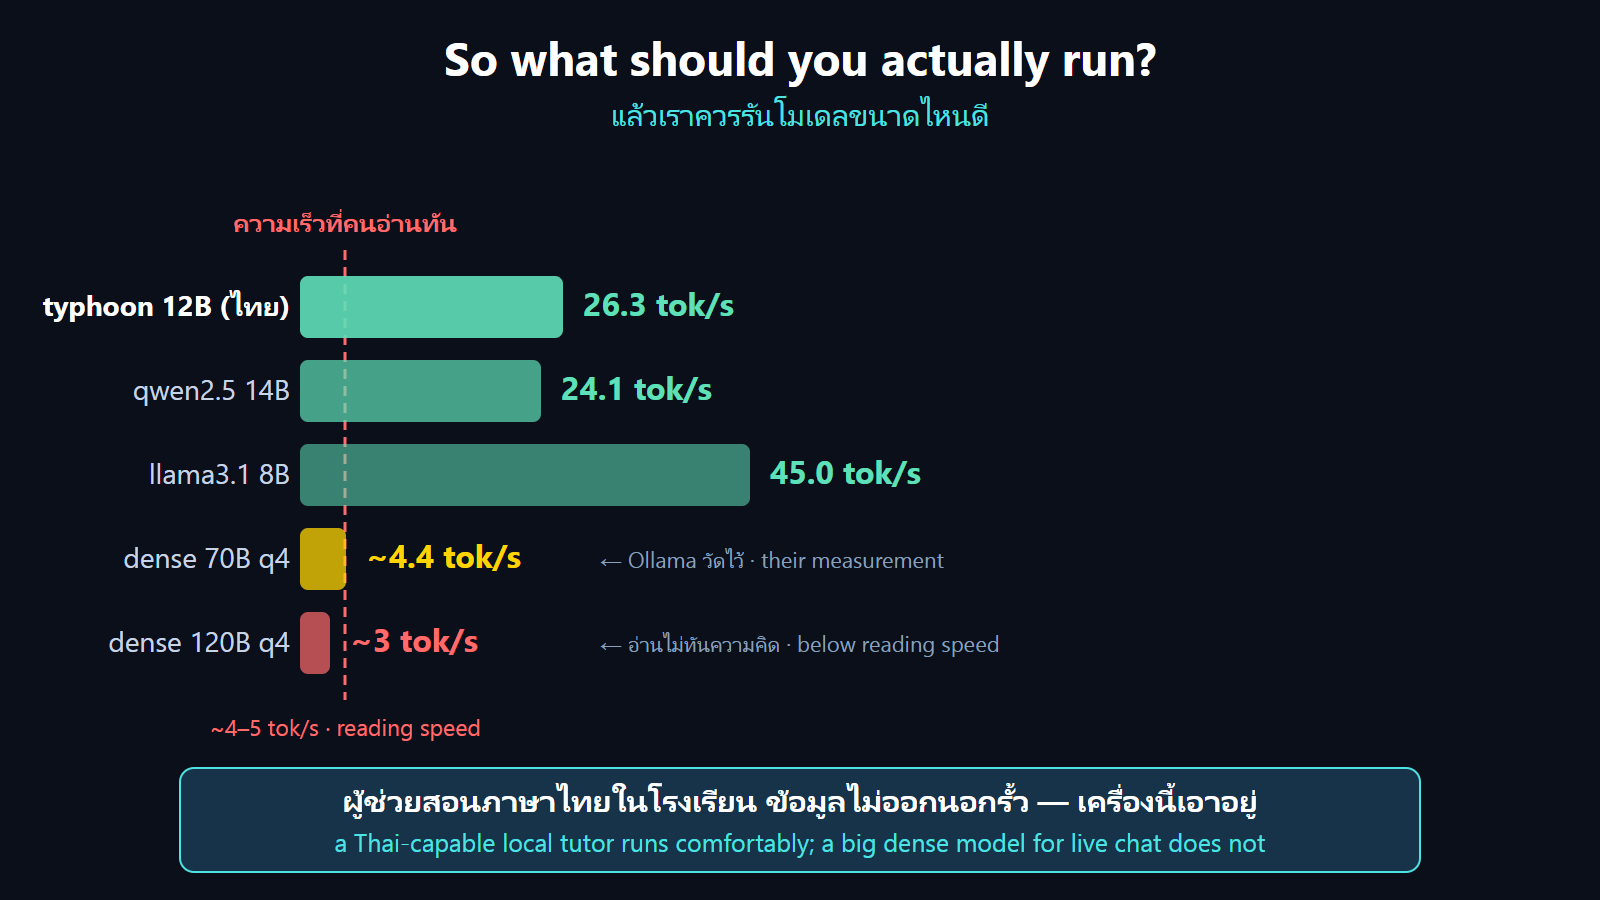
แล้วสรุปเราควรรันโมเดลขนาดไหนดีคะ กติกาเดิมตอบให้ได้เลยค่ะ เอาความเร็วขนข้อมูล หารด้วยขนาดโมเดลที่อยากรัน ก็จะรู้คร่าวๆ ว่าจะได้กี่คำต่อวินาที คนอ่านหนังสือทั่วไป อ่านได้ประมาณสองร้อยถึงสองร้อยห้าสิบคำต่อนาที ถ้าโมเดลเขียนได้เร็วกว่านั้น เราก็จะรู้สึกว่ามันลื่นแล้วค่ะ อย่างโมเดลภาษาไทยที่เราลอง คือ ไต้ฝุ่น ขนาดสิบสองพันล้าน เขียนได้ยี่สิบหกคำต่อวินาที รอแค่สามส่วนสิบวินาทีก็เริ่มตอบแล้ว เร็วกว่าที่เราอ่านทันสบายๆ เลยค่ะ แปลว่าถ้าจะทำผู้ช่วยสอนภาษาไทย ไว้ใช้เองในโรงเรียน โดยข้อมูลไม่ต้องออกไปไหนเลย เครื่องแบบนี้เอาอยู่ค่ะ แต่ถ้าจะรันโมเดลใหญ่มากๆ ให้คนเดียวคุยสดๆ อันนั้นคนละเรื่องกันนะคะ
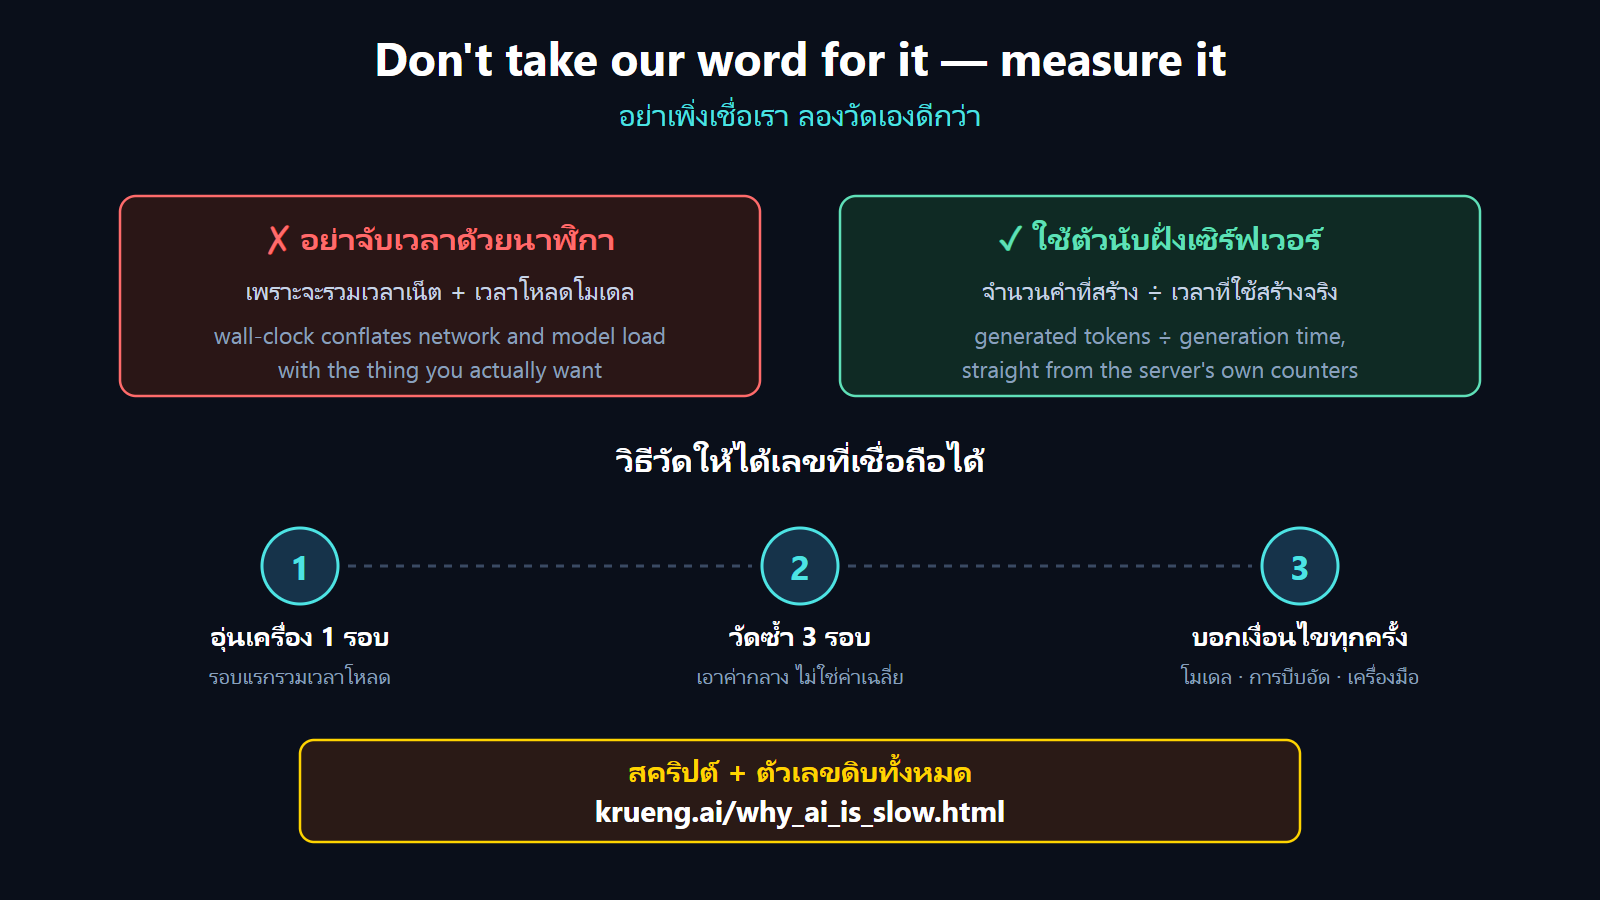
แล้วถ้าอยากลองวัดเองบ้างล่ะคะ ทำได้ไม่ยากเลย อย่าเพิ่งเชื่อเรานะคะ ลองเองดีกว่า อย่าจับเวลาด้วยนาฬิกาข้อมือนะคะ เพราะมันจะรวมเวลาเน็ต เวลาโหลดโมเดล เข้าไปด้วย ให้ใช้ตัวนับเวลาที่ฝั่งเซิร์ฟเวอร์มีอยู่แล้วค่ะ เอาจำนวนคำที่สร้างได้ หารด้วยเวลาที่ใช้สร้างจริงๆ ก็ได้ความเร็วตอนเขียน แล้ววัดซ้ำสามรอบ เอาค่ากลาง อุ่นเครื่องก่อนหนึ่งรอบ เพราะรอบแรกจะรวมเวลาโหลดโมเดลเข้าไปด้วยค่ะ สคริปต์ที่เราใช้วัด กับตัวเลขดิบทั้งหมด เราวางไว้ให้ในหน้าเว็บแล้วนะคะ เอาไปลองได้เลยค่ะ
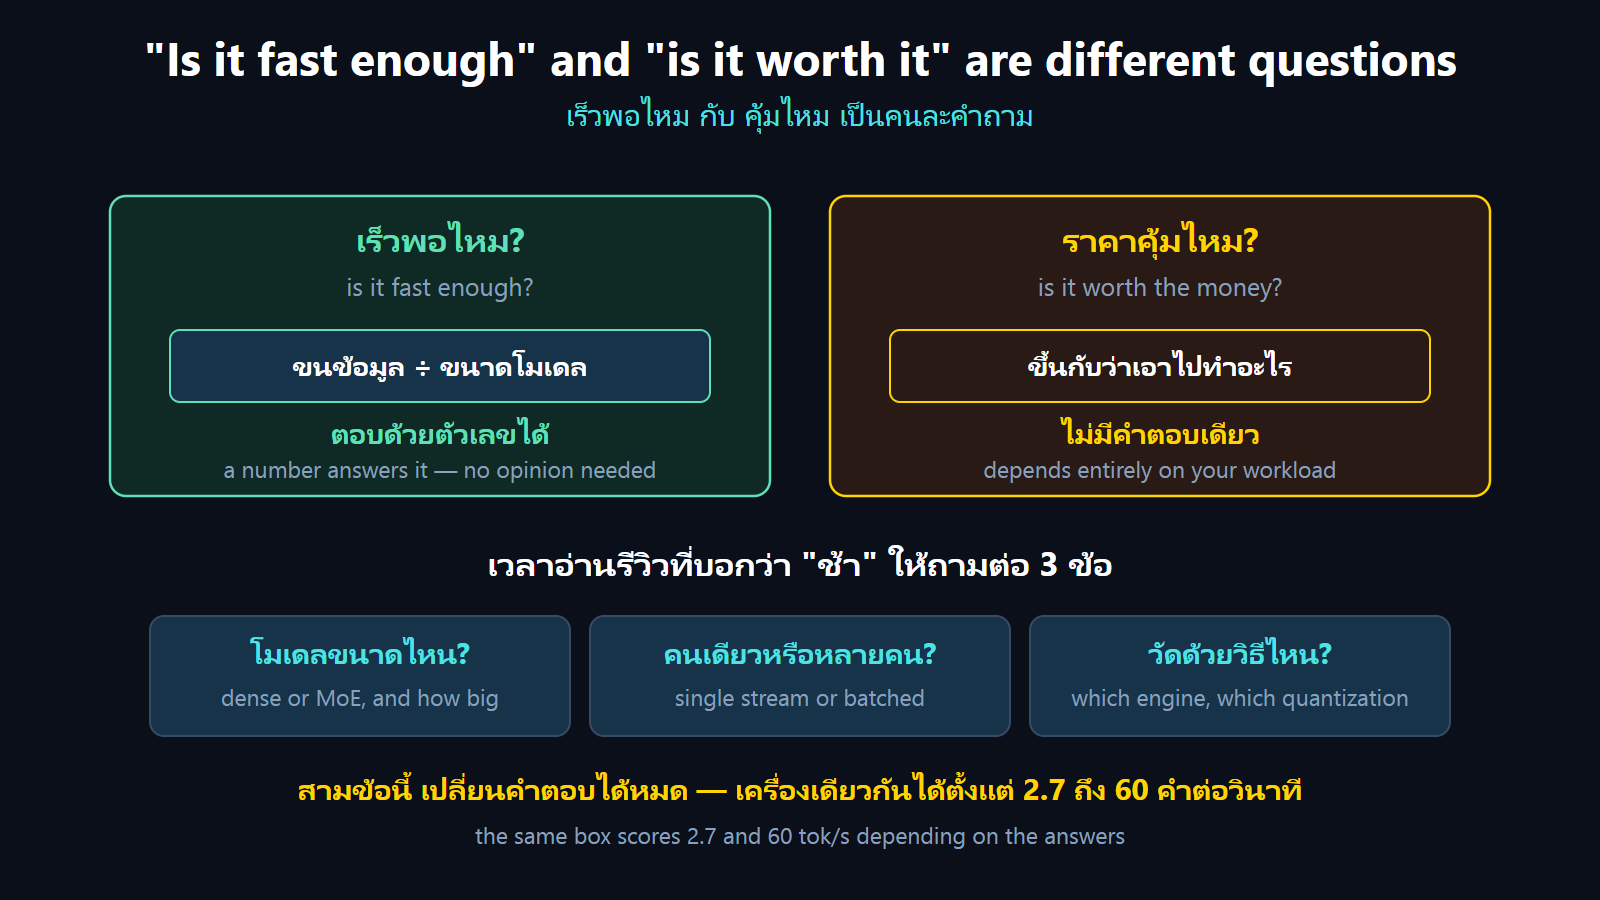
ทีนี้คำถามที่เจอบ่อยที่สุดค่ะ แล้วมันคุ้มไหม ตรงนี้ต้องแยกให้ชัดนะคะ เพราะคนมักเอาสองคำถามมาปนกัน คำถามแรกคือ มันเร็วพอไหม อันนี้ตอบด้วยตัวเลขได้ เอาความเร็วขนข้อมูล หารด้วยขนาดโมเดลที่เราจะใช้ ได้กี่คำต่อวินาที ก็เทียบกับความเร็วที่เราอ่านทัน จบค่ะ คำถามที่สองคือ ราคาคุ้มไหม อันนี้คนละเรื่องเลยค่ะ เพราะมันขึ้นกับว่าเราเอาไปทำอะไร เครื่องที่ถูกกว่าบางรุ่น ก็ให้ความเร็วใกล้เคียงกันในบางงาน เพราะงั้นเวลาอ่านรีวิว ให้ดูว่าเขากำลังตอบคำถามไหนอยู่ ถ้าเขาบอกว่าช้า ให้ถามต่อว่า ช้ากับโมเดลขนาดไหน ใช้คนเดียวหรือหลายคน แล้ววัดด้วยวิธีไหน สามคำถามนี้ เปลี่ยนคำตอบได้หมดเลยค่ะ
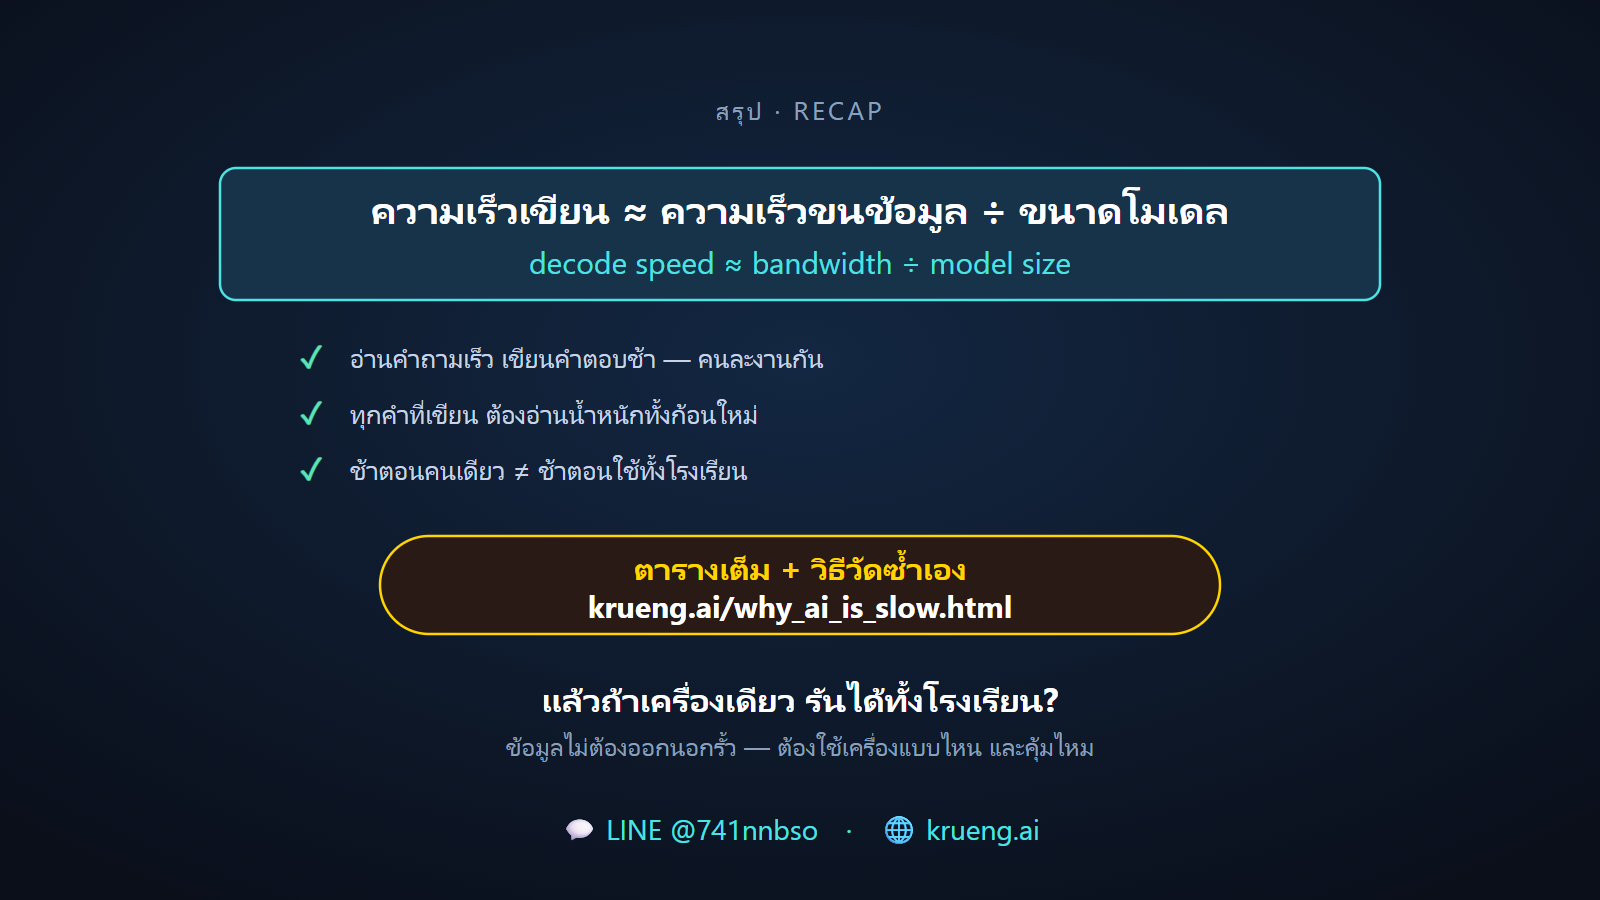
สรุปนะคะ เครื่องแรงแต่ตอบช้า เพราะตอนเขียนคำตอบ มันต้องอ่านน้ำหนักทั้งก้อนใหม่ทุกคำ คอขวดจึงอยู่ที่ความเร็วขนข้อมูล ไม่ใช่ความเร็วคำนวณ กติกาคร่าวๆ คือ ความเร็วเขียน เท่ากับ ความเร็วขนข้อมูล หารด้วยขนาดโมเดลค่ะ ตารางเต็ม ทั้งตัวเลขที่เราวัดเอง และวิธีวัดซ้ำด้วยตัวเอง อยู่ที่ krueng.ai นะคะ แล้วคำถามต่อไปที่น่าสนใจมากๆ คือ ถ้าเครื่องเดียวรันได้ทั้งโรงเรียน โดยข้อมูลไม่ต้องออกนอกรั้วเลย มันต้องใช้เครื่องแบบไหน และคุ้มไหม เดี๋ยวเรามาหาคำตอบกันค่ะ ขอบคุณที่อยู่ด้วยกันจนจบนะคะ ดูแลตัวเองด้วยค่ะ แล้วถ้าอยากคุยเรื่องนี้ต่อ หรืออยากฝึกภาษาอังกฤษกับ AI ทุกวัน แอดไลน์ครูนารีไว้ได้เลยค่ะ
เรียน AI ตั้งแต่ศูนย์ ไปด้วยกันนะคะ
ดูทั้งซีรีส์ How Machines Learn บน YouTube — ฟรีทุกตอนค่ะ